O problema: explorar custa caro
A Ramp tem um produto, o Ramp Sheets, com um agente que trabalha sobre planilhas. E um agente de planilhas é tão bom quanto a informação que ele recupera: se lê pouco, não encontra a resposta; se lê demais, fica lento, caro e fácil de distrair com abas que não têm nada a ver com a pergunta.
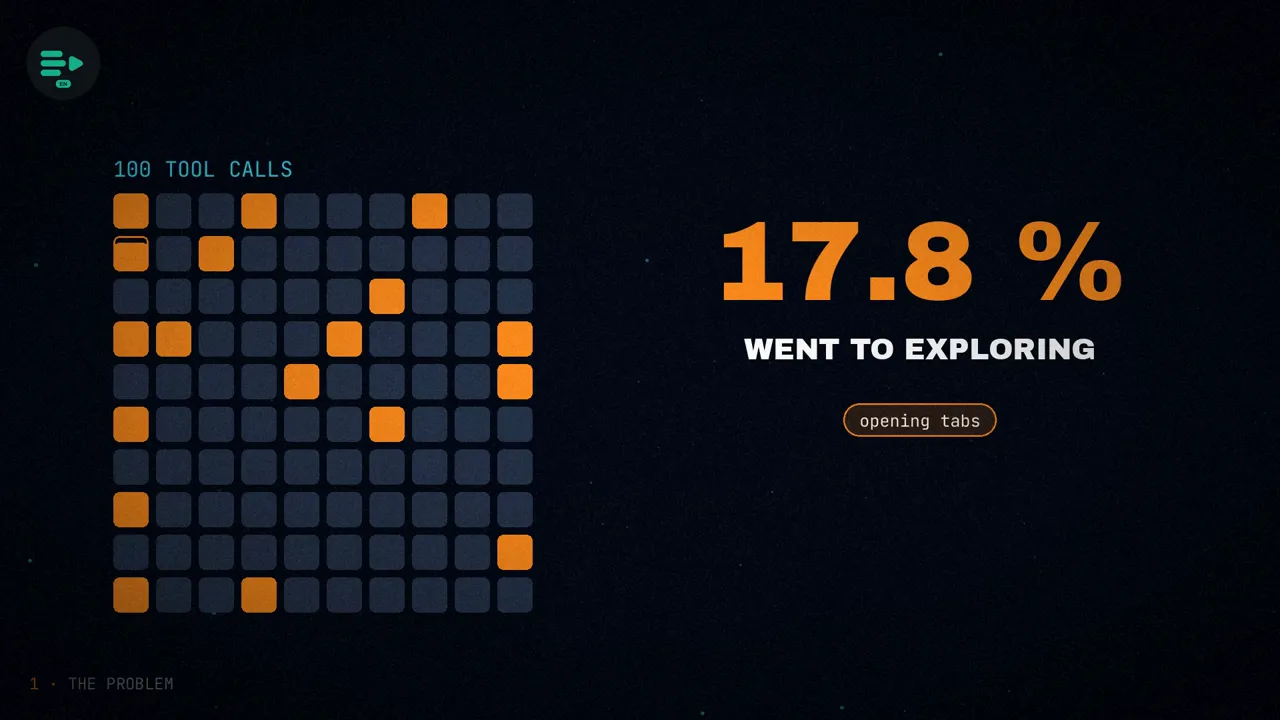
Olhando os próprios traces, eles viram quanto essa exploração custava:
- 17,8% de todas as chamadas de ferramentas do agente principal iam para abrir abas, ler intervalos e descartar planilhas irrelevantes, antes de ter os dados para responder.
- Cerca de 75% dessas chamadas eram seguidas imediatamente por outra leitura. Os autores dizem que isso sugere que o agente muitas vezes não encontrava a informação certa na primeira tentativa. É uma interpretação deles, não uma medida de falhas.
O argumento deles é que ajustar o prompt não muda o laço de fundo: continuaria sendo um modelo grande, generalista e lento navegando a planilha e filtrando o que sobra. Então levaram a busca para um subagente especializado, o Fast Ask. Ele recebe uma pergunta como «qual foi a receita de março a maio?», navega pela pasta de trabalho, lê os intervalos necessários e devolve uma resposta compacta ao agente principal.
O modelo por trás é um Qwen3.5-35B-A3B ajustado, com cerca de 3 bilhões de parâmetros ativos.
Por que um subagente
Os autores dão três razões pelas quais a recuperação merece um modelo especialista:
Se o modelo principal lê todas as abas, queima tokens em linhas irrelevantes e pode se ancorar em uma isca. O subagente devolve só as células que importam ou o valor já calculado.
Para o usuário, um agente que tem o dado na hora é muito diferente de um que gasta turnos explorando a pasta de trabalho.
A mais importante. Muitas perguntas sobre uma planilha se resolvem em um valor exato: uma data, um número de fatura, um valor em centavos, um sim ou um não, uma linha.
Essa terceira razão é a que abre a porta para o aprendizado por reforço: se a resposta é um valor exato, cada tentativa pode ser pontuada de forma determinística, sem rótulos humanos e sem outro modelo fazendo papel de juiz. A tarefa era estreita, muito repetida, sensível à latência e objetivamente pontuável. São as quatro condições que levo do artigo para decidir quando vale a pena treinar um modelo próprio.
A configuração do treinamento
Para poder treinar com reforço, eles trataram a interação com a planilha como um ambiente: muitas tarefas aparentadas, uma interface de ferramentas pequena e uma função de recompensa determinística. O modelo não aprende com demonstrações do comportamento correto; ele descobre as próprias estratégias para navegar pelas pastas de trabalho, recuperar dados e calcular respostas.
- Modelo base: Qwen/Qwen3.5-35B-A3B.
- Infraestrutura: a plataforma Lab da Prime Intellect, com o treinamento hospedado e o framework
verifiers. O ambiente de treinamento replica o harness com que o modelo é implantado em produção. - Treinamento: 100 passos, lote de 256 e 8 rollouts (tentativas) por exemplo.
- Avaliação: a cada 20 passos, com 128 exemplos reservados, avaliando o modelo base junto com o treinado.
- Sem modo de raciocínio: foi desativado para que a comparação fosse a do cenário de baixa latência que importa em produção.
Se você quiser ver de que peças é feito um ambiente desse tipo e como cada framework as resolve (entre eles o Verifiers, da Prime Intellect), contei isso no post sobre ambientes de RL para LLMs.
Planilhas sintéticas e 14 tipos de tarefa
Cada tarefa é uma pasta de trabalho sintética de empresa, uma pergunta em linguagem natural e uma resposta verdadeira. As pastas imitam fluxos reais de finanças: consolidação de receita, conciliação de faturas, análise de gastos, buscas filtradas por data e agregações que cruzam várias tabelas.
Os dados sintéticos permitem gerar muitas variações do mesmo problema, controlar a resposta com exatidão e mudar a redação sem mudar a habilidade que está sendo treinada. Eles definiram 14 tipos de tarefa em três famílias:
| Família | Tipos de tarefa |
|---|---|
| Receita (4) | net_revenue, variance_vs_target, top_order_contribution, counterfactual_fx |
| Conciliação (6) | invoice_balance, customer_balance, overdue_invoices, last_payment_date, is_invoice_fully_reconciled, invoice_location |
| Operações (4) | spend_month_total, budget_vs_actual, shared_vendor_uuid, netted_amount_2026 |
De cada tarefa geraram três variantes com redação diferente (um pedido para um relatório a investidores, um acompanhamento de cobranças, uma pergunta para um modelo de captação), para que o modelo não decore um template. As de conciliação variam ainda pela forma como a fatura é descrita, então o espaço de perguntas delas é maior do que três por tipo. Um exemplo do artigo:
I am tightening our investor memo. What cumulative net recognized revenue did South land across 2025-03 to 2025-05, in USD cents?
Essa pasta tem onze planilhas: Orders, OrderLines, Shipments, Returns, OrderMonthNet, FxExposure, Contracts, FXRates, Targets, HiringPlan e CapTable. As duas últimas não têm nada a ver com a pergunta, e isso não é por acaso.
Os lotes são montados em rodízio equilibrado: cada passada embaralha o conjunto e emite os 14 tipos antes de repetir qualquer um, de modo que todos são treinados por igual. E o mundo sintético é coerente por dentro: clientes, fornecedores, produtos, níveis de contrato e métodos de pagamento saem de vocabulários fixos, ao longo de milhares de pastas geradas.
As armadilhas
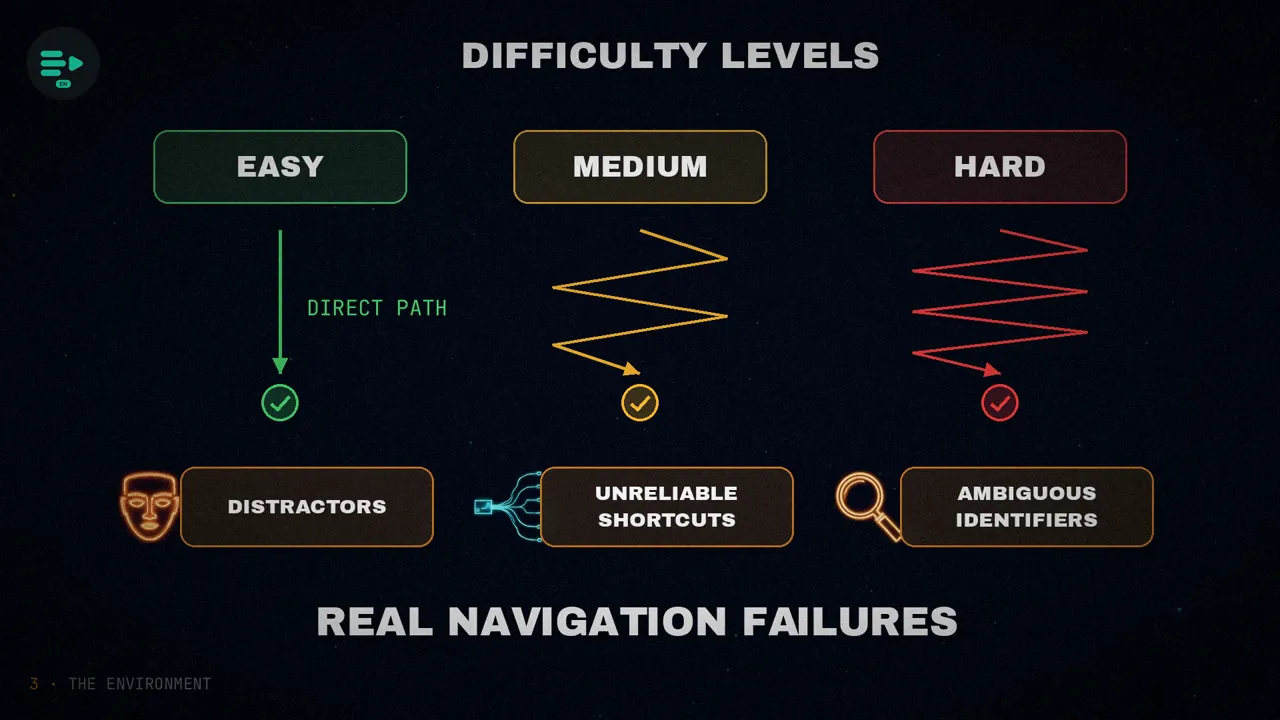
A dificuldade regula quanta pressão de navegação o modelo sofre. As tarefas fáceis costumam deixar um caminho direto até a resposta. As médias e difíceis complicam de três maneiras:
Planilhas como HiringPlan ou CapTable, com recrutadores, vagas abertas e pools de opções. Parecem finanças, mas não contêm nada que sirva para a pergunta. Quem lê sem critério gasta nelas o orçamento de turnos.
Planilhas de resumo como RegionalPnL ou SpendSummary em que faltam justamente as colunas calculadas que dariam a resposta. Parecem um atalho, mas é preciso verificar ou agregar a partir dos dados de origem. No nível difícil, elas somem.
Em cerca de 15-20% das tarefas de conciliação, a pergunta não cita a fatura pelo código INV-####, e sim por pistas do pagamento (sistema, método, data, valor) ou por uma assinatura (cliente, mês, valor, vencimento). Antes de responder, é preciso resolver de que fatura se trata.
Três ferramentas e quinze turnos
O modelo tem três ferramentas e um orçamento de 15 turnos:
get_workbook_metadatadevolve os nomes das planilhas, as cores das abas e o intervalo usado aproximado.read_rangesdevolve os dados das células, com um teto de 1.000 células por chamada. Pedidos maiores são rejeitados.run_pythonexecuta Python isolado, só com a biblioteca padrão. O estado persiste entre chamadas dentro de uma mesma tentativa.
Serem tão poucas é proposital: com apenas três ferramentas, fica mais fácil para a recompensa distinguir uma trajetória eficiente de uma que desperdiça turnos.
A recompensa
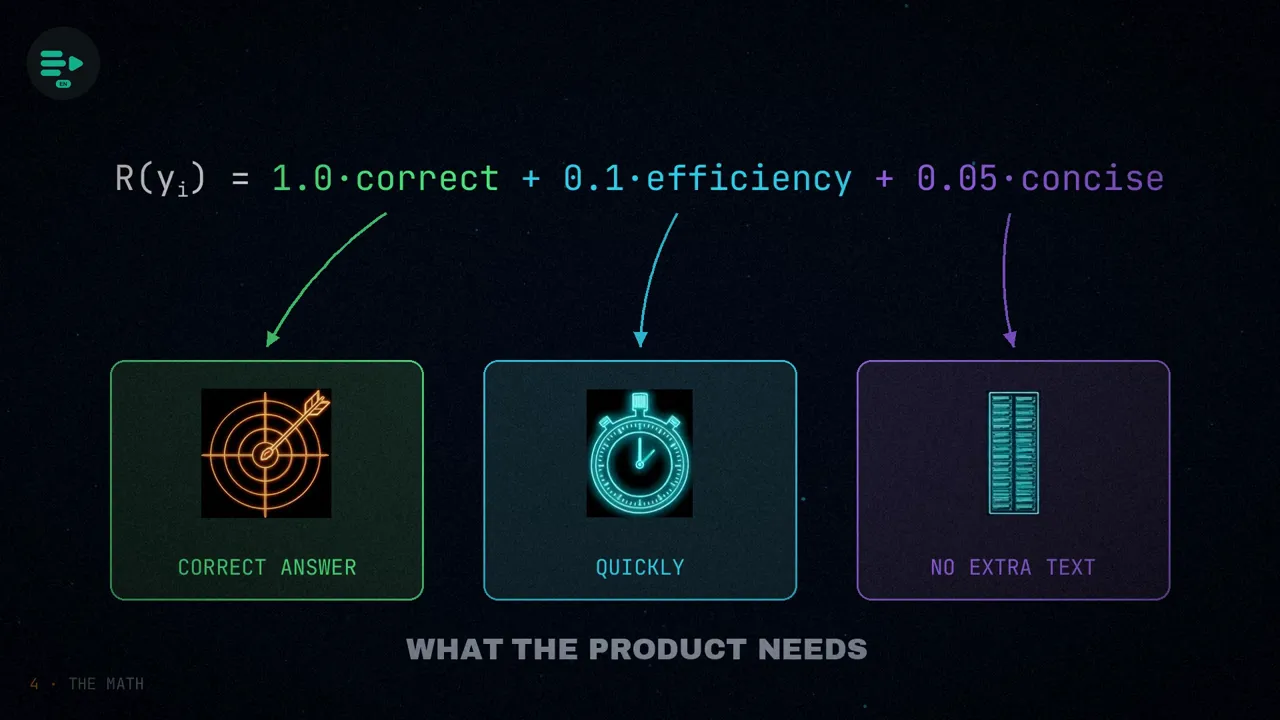
Para cada pergunta, o modelo gera oito trajetórias. Uma trajetória é o trace completo: as chamadas de ferramentas, as leituras, o Python executado e a resposta final. O verificador pontua cada uma com uma função que cabe em uma linha:
R(y) = 1,0 · correct(y) + 0,1 · efficiency(y) + 0,05 · concise(y)A recompensa copia o que o Fast Ask precisa em produção: dar a resposta certa, dar rápido e não colocar texto a mais no contexto do agente principal.
- Acertar manda. O termo de 1,0 só é ativado se a linha final
ANSWER:puder ser interpretada no tipo esperado e coincidir exatamente com o gabarito. - Eficiência e concisão são ajustes finos. Não salvam uma resposta errada, mas ordenam as corretas: acertar em cinco turnos pontua um pouco mais do que acertar depois de passear por planilhas irrelevantes.
GRPO: a vantagem frente ao grupo
Eles treinaram com GRPO, um método de gradiente de política que estima a vantagem a partir de grupos de tentativas geradas para a mesma pergunta. Em vez de treinar um modelo de valor separado, ele compara a recompensa de cada tentativa com a das outras do grupo. Com G = 8 tentativas, a vantagem da tentativa i pode ser escrita assim:
A_i = R(y_i) − (1/G) · Σ_k R(y_k)Ou seja, a sua vantagem é a sua nota menos a média do grupo. Para a mesma pergunta, uma tentativa acerta em cinco turnos e outra gasta o orçamento em abas-isca e falha: essa diferença é o sinal de aprendizado. Deixando de lado a correção off-policy, a atualização tem esta forma:
∇J(θ) ≈ Σ_i Σ_t A_i · ∇ log π_θ(y_i,t | x, y_i,<t)Cada token de uma trajetória é reforçado ou atenuado conforme a vantagem da trajetória inteira. É isso que faz o reforço combinar com agentes que usam ferramentas: ninguém rotula qual era a próxima chamada correta, só se pontua o resultado final. A matemática empurra a probabilidade para o que fez a resposta ser correta: ler primeiro os metadados, desviar das abas-isca, usar os resumos quando valem, voltar às linhas de origem quando não valem e emitir uma linha ANSWER: que possa ser interpretada.
É o mesmo algoritmo com que o NapMem foi treinado para navegar pela própria memória.
Assíncrono e off-policy
No Fast Ask, uma tentativa é uma trajetória de vários turnos: olhar os metadados, ler intervalos, executar Python e responder. Gerar essas tentativas é muito mais lento do que carregar dados em um ajuste fino supervisionado comum. Se o treinamento tivesse que parar depois de cada atualização para esperar trajetórias recém-geradas, as GPUs passariam muito tempo paradas.
A pilha prime-rl da Prime Intellect resolve isso com treinamento assíncrono e off-policy: os geradores de tentativas continuam produzindo trajetórias enquanto o treinador atualiza o modelo. Algumas trajetórias vêm de uma versão um pouco mais antiga da política, e o objetivo corrige essa defasagem, que é limitada, com pesos de importância:
ρ_t(θ) = π_θ(y_t | x, y_<t) / π_gen(y_t | x, y_<t)A razão ρ responde a uma pergunta simples: quão mais ou menos provável é que o modelo atual produza este token, comparado com o modelo que o gerou? Para manter as atualizações estáveis, a Prime Intellect usa um objetivo ponderado por importância e com recorte, no estilo AIPO:
J(θ) = Σ_i,t min( ρ_i,t(θ) · A_i , clip(ρ_i,t(θ), 1 − ε, 1 + ε) · A_i )O recorte limita quanto pode pesar um token cuja probabilidade mudou muito desde que foi gerado, de modo que uma trajetória antiga não puxe o modelo mais do que deveria.
Resultados
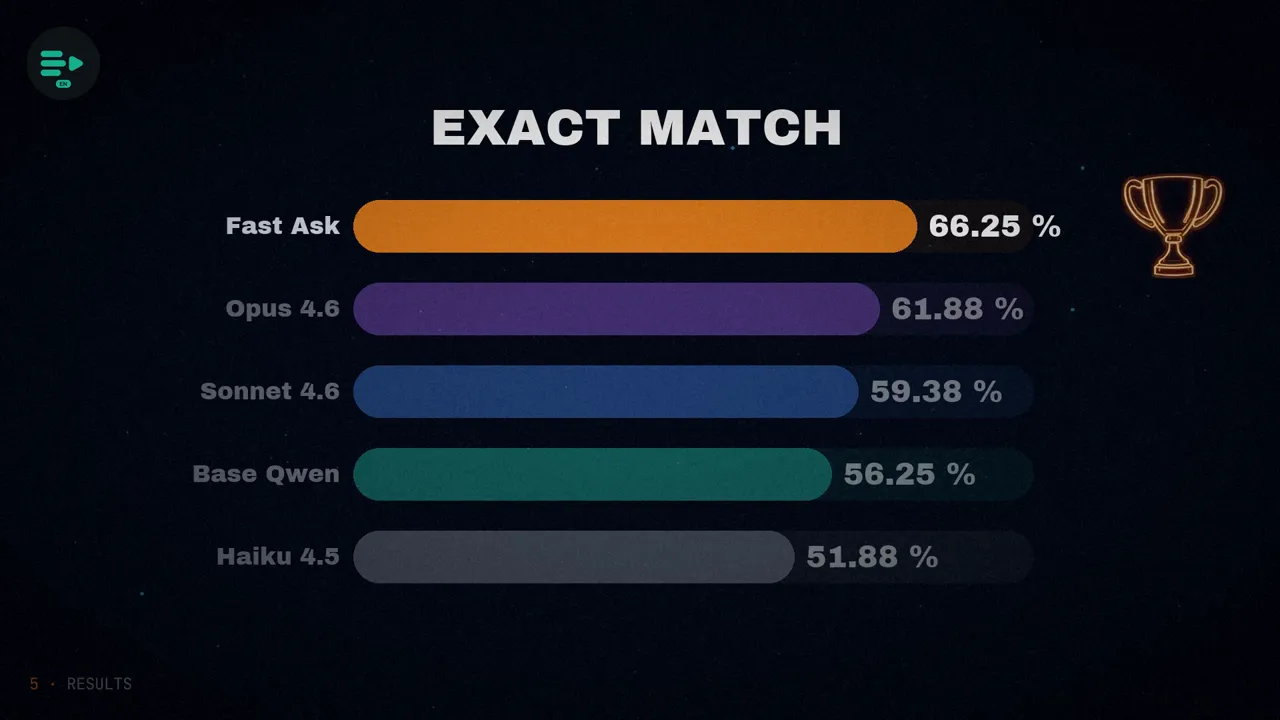
Eles avaliaram o modelo base e o treinado junto com a família Claude, em tarefas reservadas. As métricas são o acerto exato e o tempo real por tentativa, relativo ao do Haiku 4.5:
| Modelo | Acerto exato | Tempo frente ao Haiku 4.5 |
|---|---|---|
| Fast Ask (Qwen treinado) | 66,25% | 1,05× |
| Claude Opus 4.6 | 61,88% | 1,44× |
| Claude Sonnet 4.6 | 59,38% | 1,60× |
| Qwen3.5-35B-A3B base | 56,25% | 1,34× |
| Claude Haiku 4.5 | 51,88% | 1,00× |
- Dez pontos sobre o modelo base (de 56,25% para 66,25%), e ainda levando menos tempo: de 1,34× para 1,05×.
- Pouco mais de quatro pontos sobre o Opus 4.6 (66,25 − 61,88 = 4,37), com um tempo muito próximo do Haiku 4.5.
- O treinamento durou cerca de 26 horas para os 100 passos.
O que o modelo aprendeu
Segundo os autores, quase toda a melhora veio de duas coisas: o modelo aprendeu a dar respostas no formato exato, que podem ser interpretadas, e a planejar trajetórias mais enxutas, que desperdiçam menos turnos.
E há um dado que me parece o mais fino do artigo: o total de células lidas por tentativa ficou mais ou menos estável durante todo o treinamento (no gráfico deles, em torno de 2.400). O modelo não aprendeu a ler menos; aprendeu a distribuir melhor as leituras. Na mesma figura, as células por turno sobem, de umas 200 para umas 350, enquanto o total não se mexe: ele lê o mesmo em menos viagens. Essa última parte é leitura minha do gráfico; o texto só fala do total.
O que não bate e o que não dá para concluir
Comparando o texto com as figuras do próprio artigo, há dois detalhes que não batem:
- A curva de recompensa. O texto diz que a recompensa subiu de cerca de 0,2 para cerca de 0,8 nos primeiros 40 passos e depois estabilizou. No gráfico animado que acompanha o artigo, a curva começa perto de 0,5, cai para perto de 0,3 e sobe aos poucos até rondar 0,8 perto do passo 100. Coincidem em onde termina, não no caminho.
- O tamanho da avaliação. O artigo fala em 128 exemplos reservados para as avaliações intermediárias. Mas as porcentagens da tabela final são múltiplos exatos de 1/160 (106, 99, 95, 90 e 83 acertos em 160) e não de 1/128. Então a tabela parece vir de outro conjunto, de 160 exemplos, que o artigo não descreve. É uma dedução minha, não um dado dos autores.
Nenhuma das duas muda a conclusão, mas convém ler os números com os seus limites:
- Não é «o Qwen ganha do Opus» em geral. É uma tarefa de recuperação específica, na avaliação dos autores, com tarefas sintéticas do mesmo ambiente e sem modo de raciocínio.
- Não se sabe se vale igual para planilhas reais. O artigo não traz resultados com pastas de clientes.
- O custo não está quantificado. Eles dizem que é «uma fração do custo e da latência» de um modelo de fronteira, sem dar o número do custo.
- A velocidade é «aproximadamente» a do Haiku: 1,05×, não 1,00×.
Em resumo
O pós-treinamento com reforço funcionou aqui porque o ambiente tornou a busca em planilhas mensurável e repetível: decisões repetidas com um resultado claro, sem trajetórias rotuladas por humanos nem um LLM como juiz. Os autores insistem que o trabalho importante não esteve na arquitetura nem no tamanho do modelo, e sim no design do ambiente: as tarefas certas, uma interface mínima de ferramentas e uma recompensa colada em como o produto funciona em produção.
E apresentam isso como um padrão que pretendem repetir: treinar subagentes pequenos e verificáveis para gargalos estreitos, e deixar os modelos de fronteira gastarem tokens em julgar, não em buscar.
Se uma tarefa é estreita, se repete muito, a latência importa e a resposta pode ser verificada, um modelo pequeno treinado em um bom ambiente pode fazê-la melhor do que um grande.
Que gargalo do seu agente cumpre as quatro?
Fontes
- «Building Fast & Accurate Agents with Prime-RL Post Training», da Ramp Labs, com Ben Geist e Will Brown, 7 de maio de 2026.
- Sobre ambientes e reforço neste blog: ambientes de RL para LLMs e NapMem, outro agente treinado com GRPO.
- O vídeo, nos meus canais: inglês e espanhol.