Agente = modelo + arnês
A ideia cabe numa fórmula: agente = modelo + arnês (em inglês, harness). E vem com uma regra fácil de lembrar: se você não é o modelo, você é o arnês.
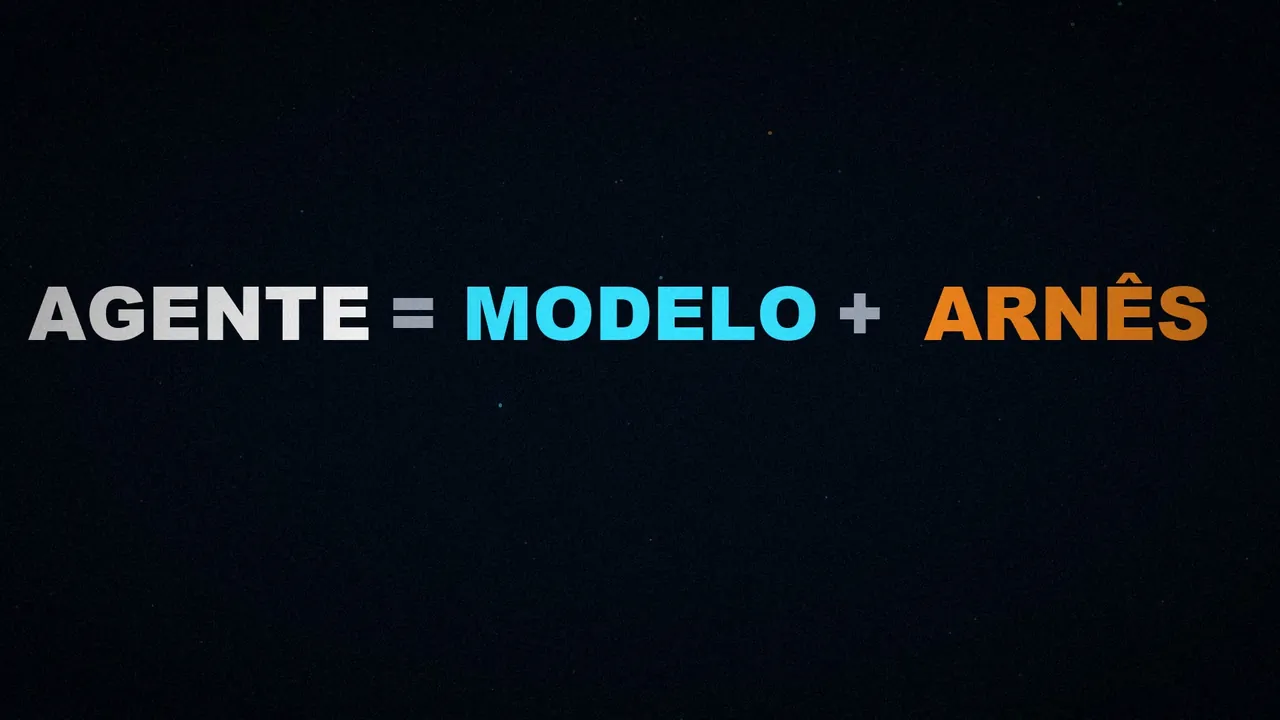
Um arnês é todo o código, a configuração e a lógica de execução que não são o modelo. Um modelo bruto não funciona como agente. Ele começa a funcionar quando o arnês lhe dá estado, execução de ferramentas, ciclos de realimentação e restrições que são cumpridas de qualquer jeito.
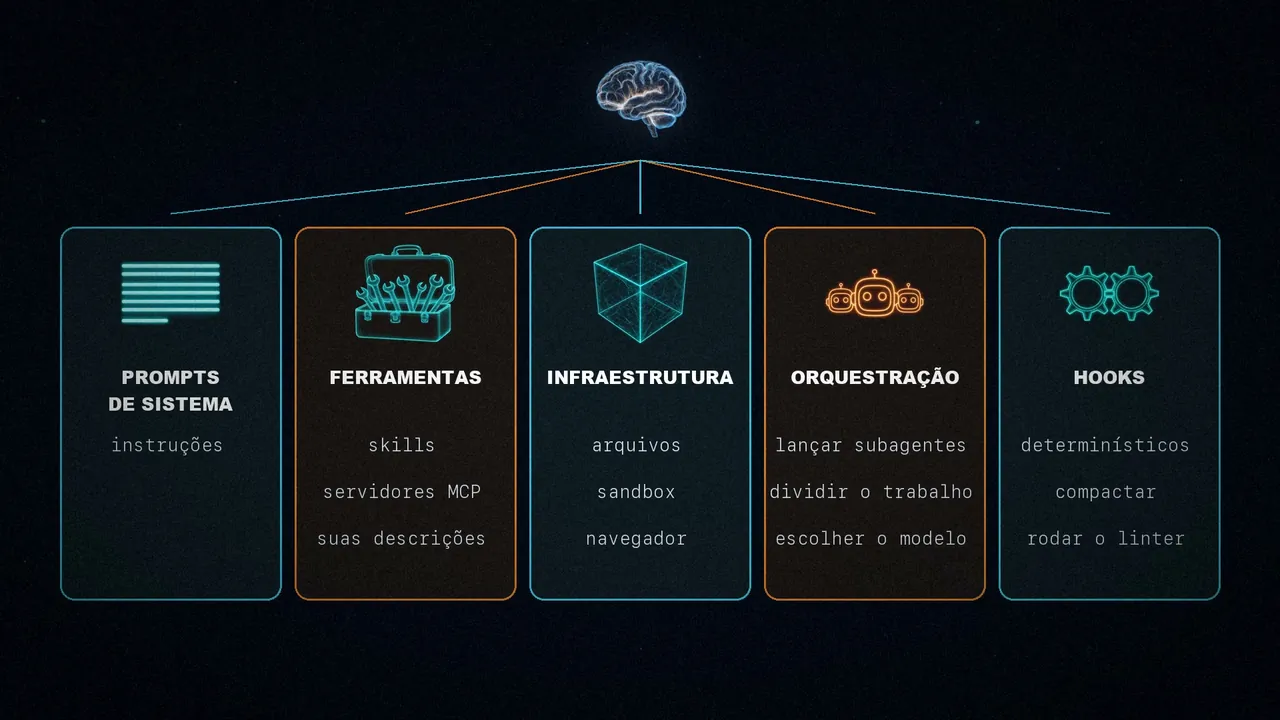
Concretamente, um arnês inclui cinco coisas:
- Prompts de sistema. As instruções de partida.
- Ferramentas, skills e servidores MCP, com as suas descrições.
- Infraestrutura incluída: sistema de arquivos, sandbox e navegador.
- Orquestração: lançar subagentes, dividir o trabalho e escolher o modelo.
- Hooks ou middleware: passos determinísticos, como compactar, fazer o agente continuar ou rodar o linter.
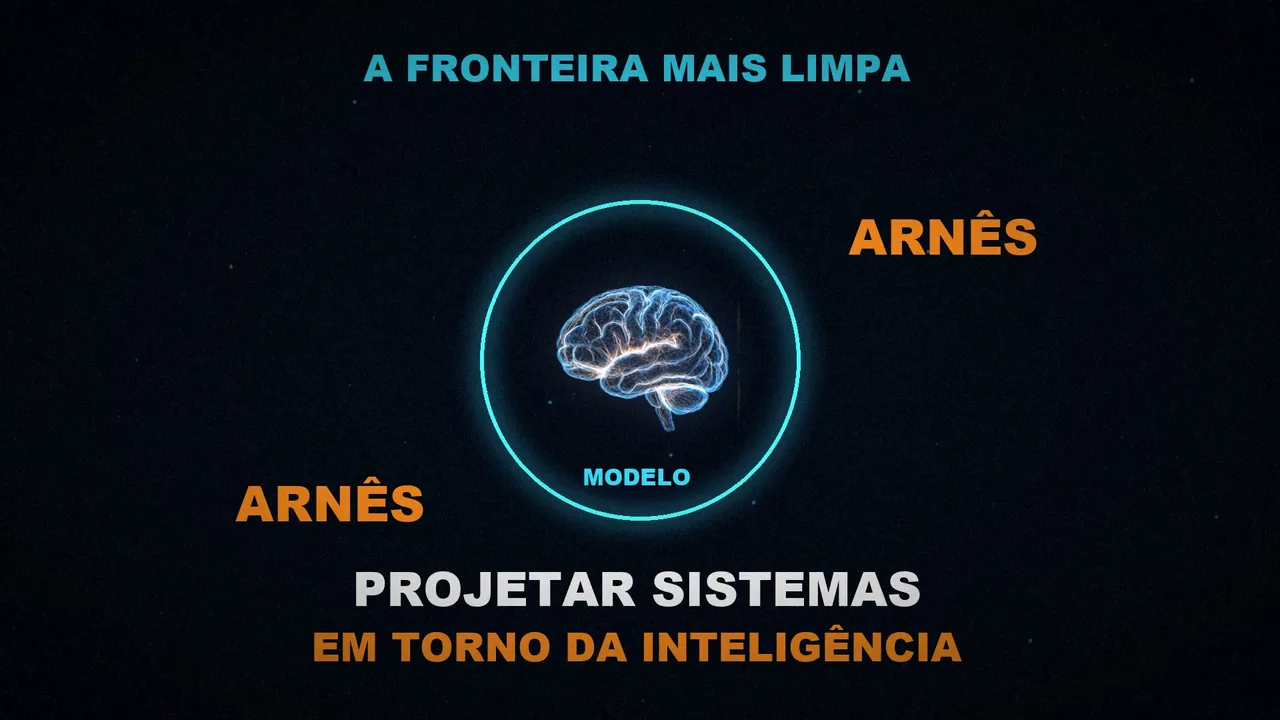
A fronteira mais limpa
Há muitas formas complicadas de separar o modelo do arnês. Vivek defende esta por considerá-la a mais limpa: ela nos obriga a pensar em como projetar sistemas em torno da inteligência do modelo. E a partir daí o artigo deduz, de trás para a frente, por que cada peça existe.
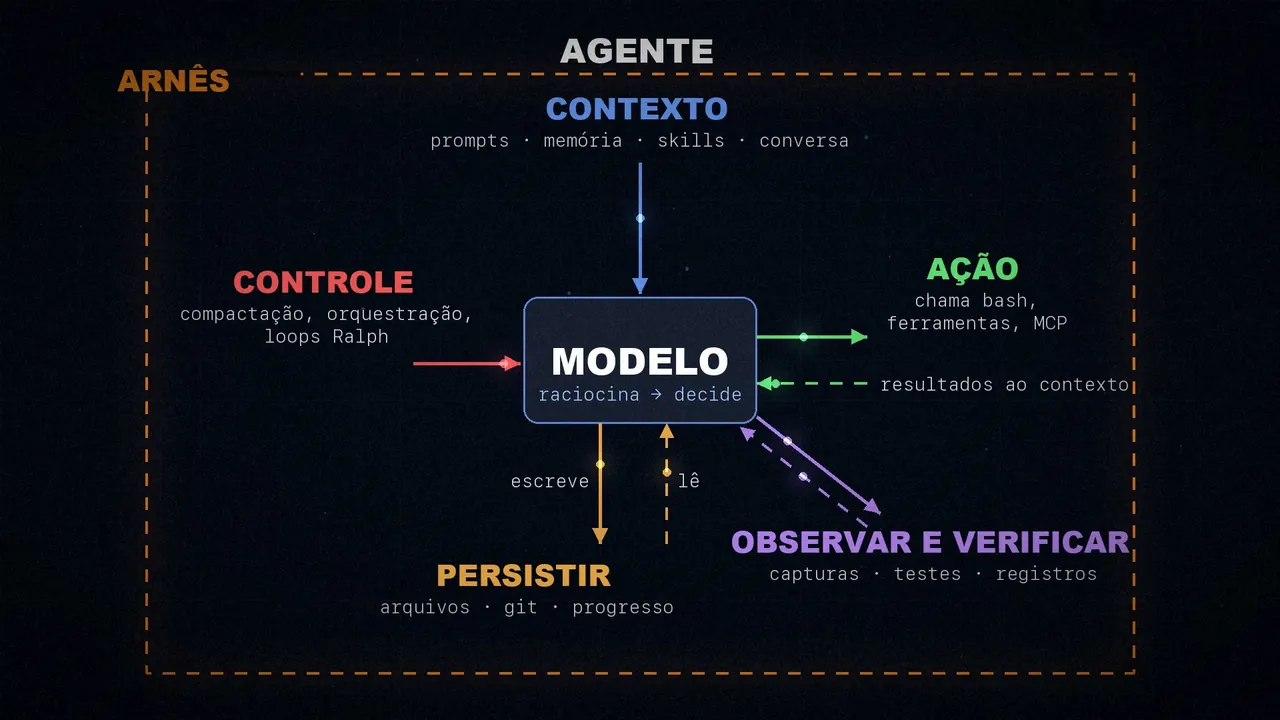
O artigo resume isso num esquema. No centro está o modelo, que raciocina e decide. De cima entra o contexto: prompts, memória, skills e a conversa. À direita ele age: chama o bash, ferramentas e servidores MCP, e os resultados voltam ao contexto. Embaixo ele persiste: escreve e lê arquivos, git e arquivos de progresso. Na diagonal ele observa e verifica, com capturas do navegador, resultados de testes e registros. E à esquerda fica o controle: compactação, orquestração e loops Ralph.
Por que precisamos de um arnês
Coloque-se no lugar do modelo. Quase todos recebem dados, como texto, imagens, áudio ou vídeo, e devolvem texto. Só isso. De fábrica, eles não conseguem:
- Manter um estado durável entre interações.
- Executar código.
- Acessar conhecimento em tempo real.
- Preparar ambientes e instalar pacotes para terminar um trabalho.
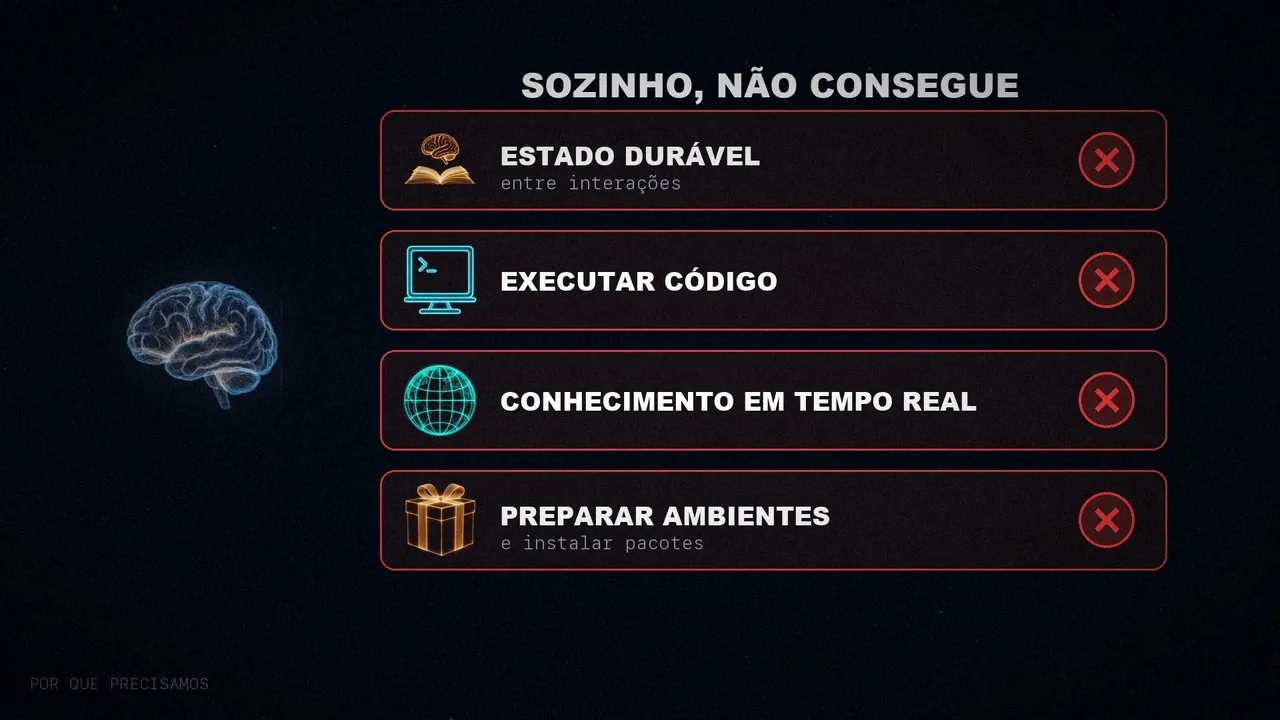
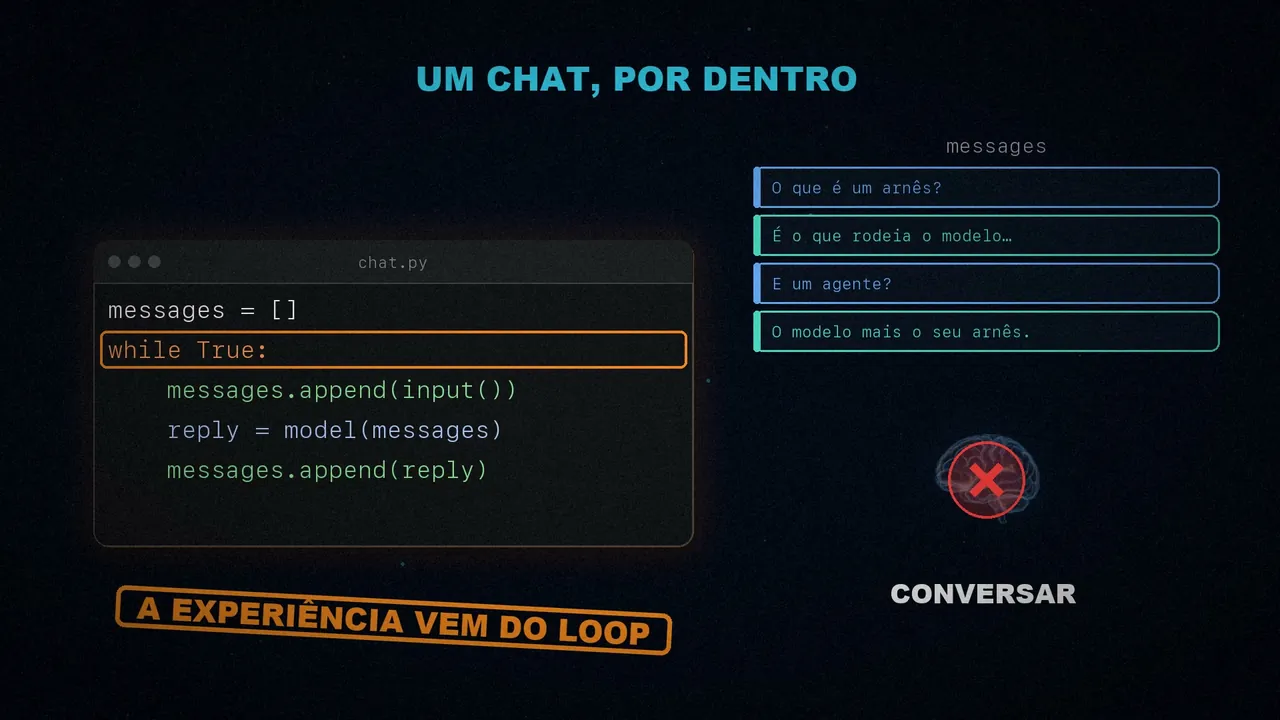
Tudo isso são funções do arnês. E com certeza você já usou um sem saber: para conversar com um modelo, nós o envolvemos num loop while que guarda as mensagens anteriores e adiciona cada mensagem nova sua. Essa experiência de conversar não vem do modelo. Vem desse loop.
Trabalhar de trás para a frente
Daí sai a ideia central: transformar o comportamento que queremos do agente numa função real do arnês. Isso se chama engenharia de arneses (harness engineering). Serve para injetar conhecimento prévio que guie o agente e, como os modelos estão cada vez mais capazes, também para estendê-los e corrigi-los com precisão de cirurgião.
Por isso o artigo segue sempre o mesmo padrão: primeiro, o comportamento que queremos; depois, o que o arnês adiciona para consegui-lo. Saem seis pares. Não pretende ser uma lista completa: o importante é que cada peça nasce de algo que o modelo não pode oferecer por si mesmo.
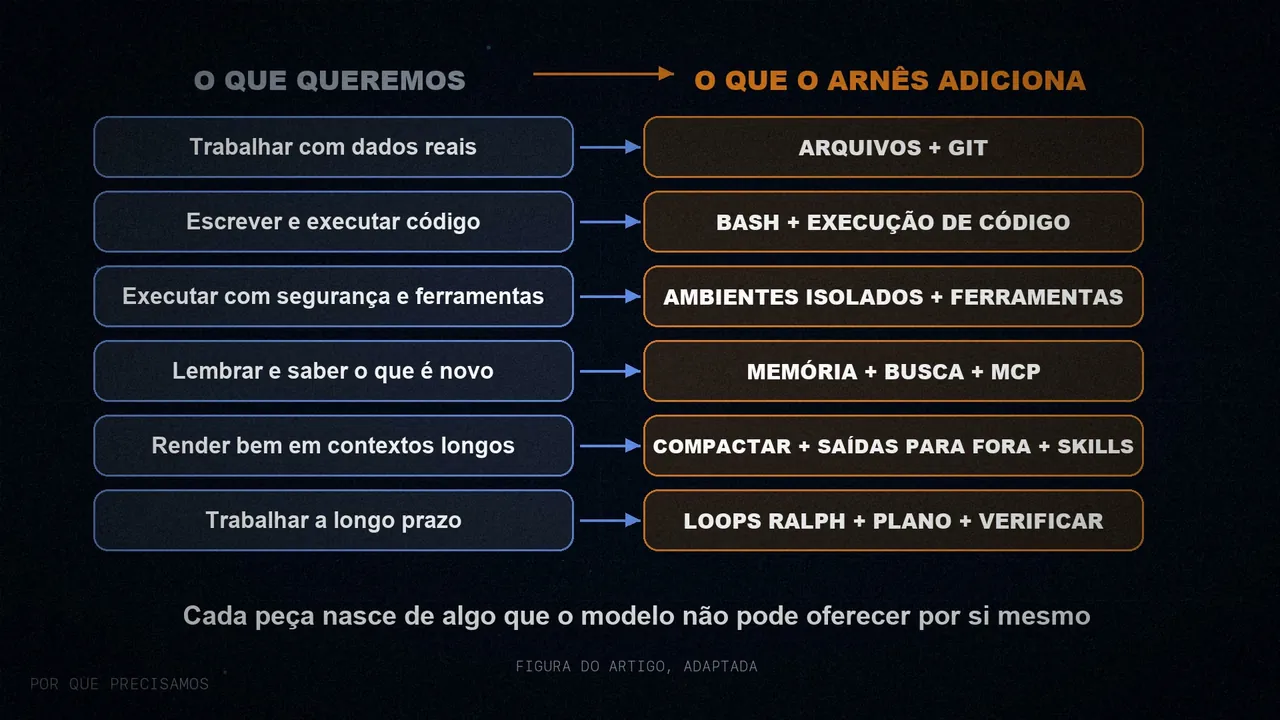
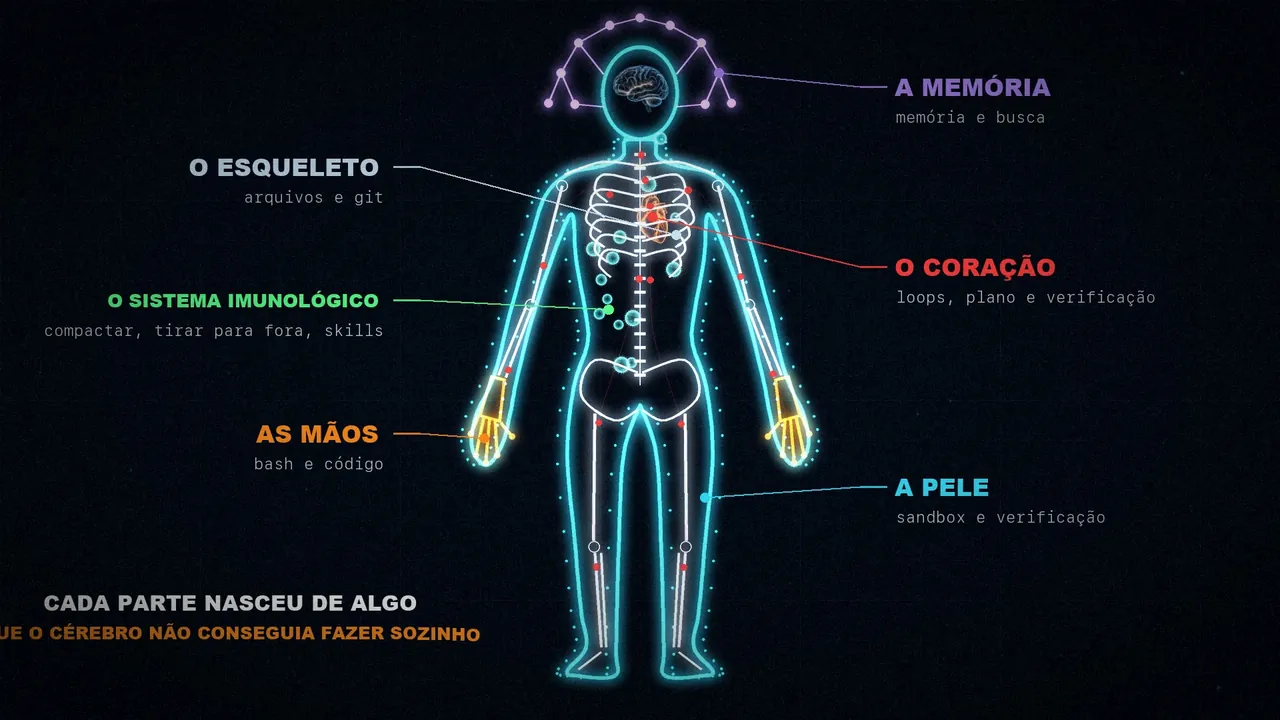
Como isto é sobre anatomia, no vídeo eu monto essas seis peças como um corpo, e mantenho a imagem aqui porque ajuda a lembrar delas. O modelo é o cérebro. A metáfora é minha, não do artigo.
1. Arquivos: o esqueleto
Queremos que o agente trabalhe com dados reais, guarde o que não cabe no contexto e conserve o seu trabalho entre sessões. Mas o modelo só opera sobre o que está dentro da sua janela. Antes era preciso copiar e colar à mão, algo incômodo que não serve para um agente autônomo.
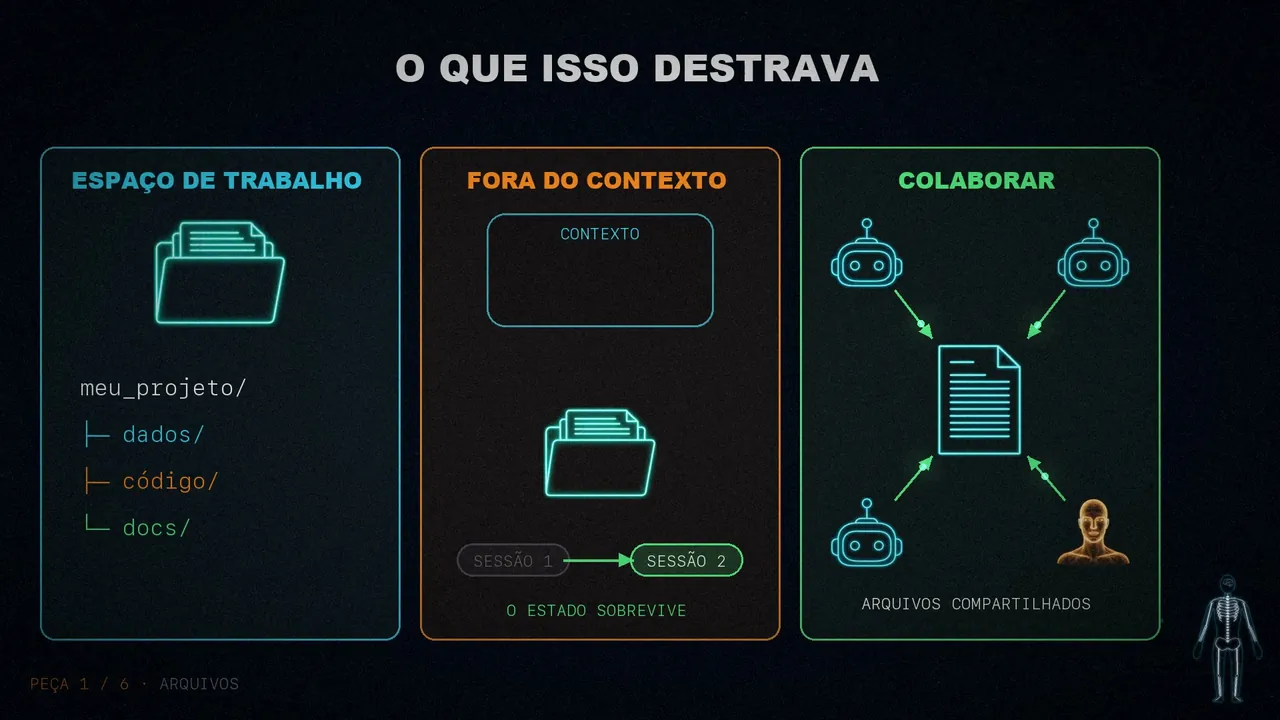
A solução veio sozinha. O mundo já trabalhava com arquivos, então os modelos foram treinados com bilhões de tokens que ensinam a usá-los. Por isso os arneses já trazem um sistema de arquivos e ferramentas para lidar com ele. Vivek a considera talvez a peça mais fundamental, pelo que ela destrava:
O agente tem onde ler dados, código e documentação.
Pode ir guardando resultados intermediários, sem manter tudo na janela, e conservar um estado que sobrevive à sessão.
Vários agentes e pessoas se coordenam com arquivos compartilhados.
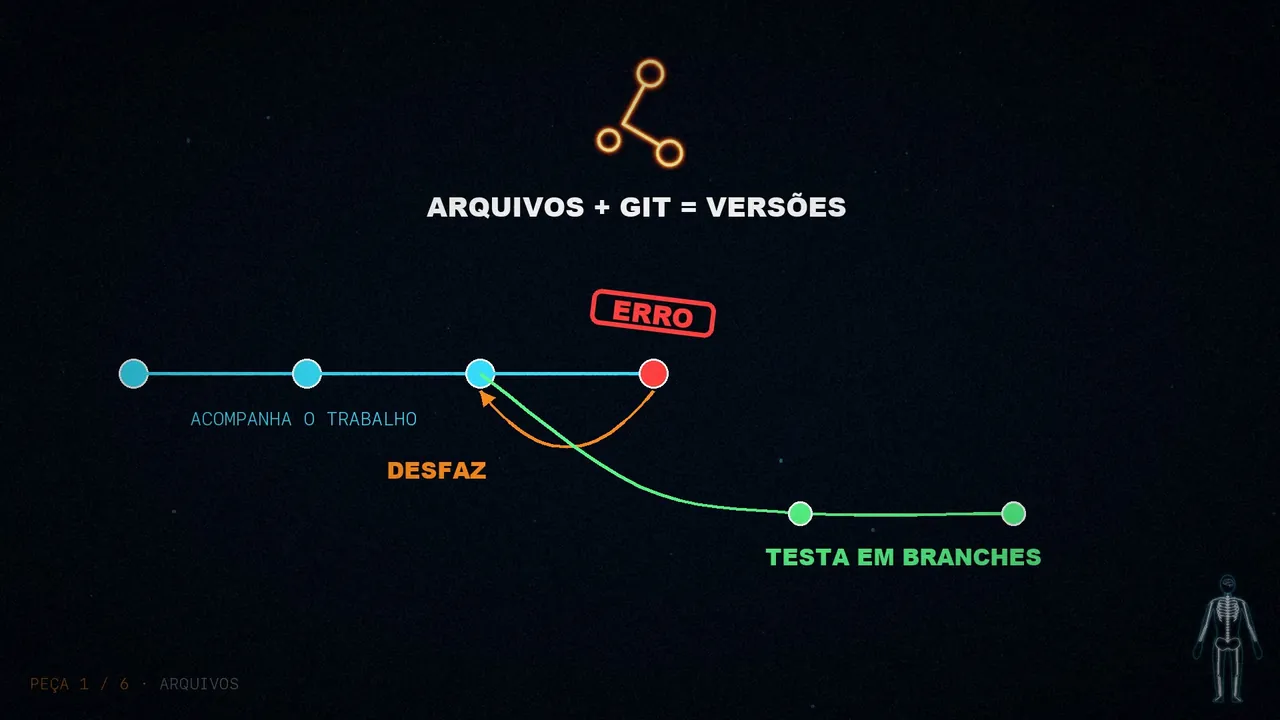
Adicione o git e ele passa a ter versões: acompanha o trabalho, desfaz erros e testa experimentos em branches. Vale lembrar desta peça, porque várias das próximas se apoiam nela.
2. Bash e código: as mãos
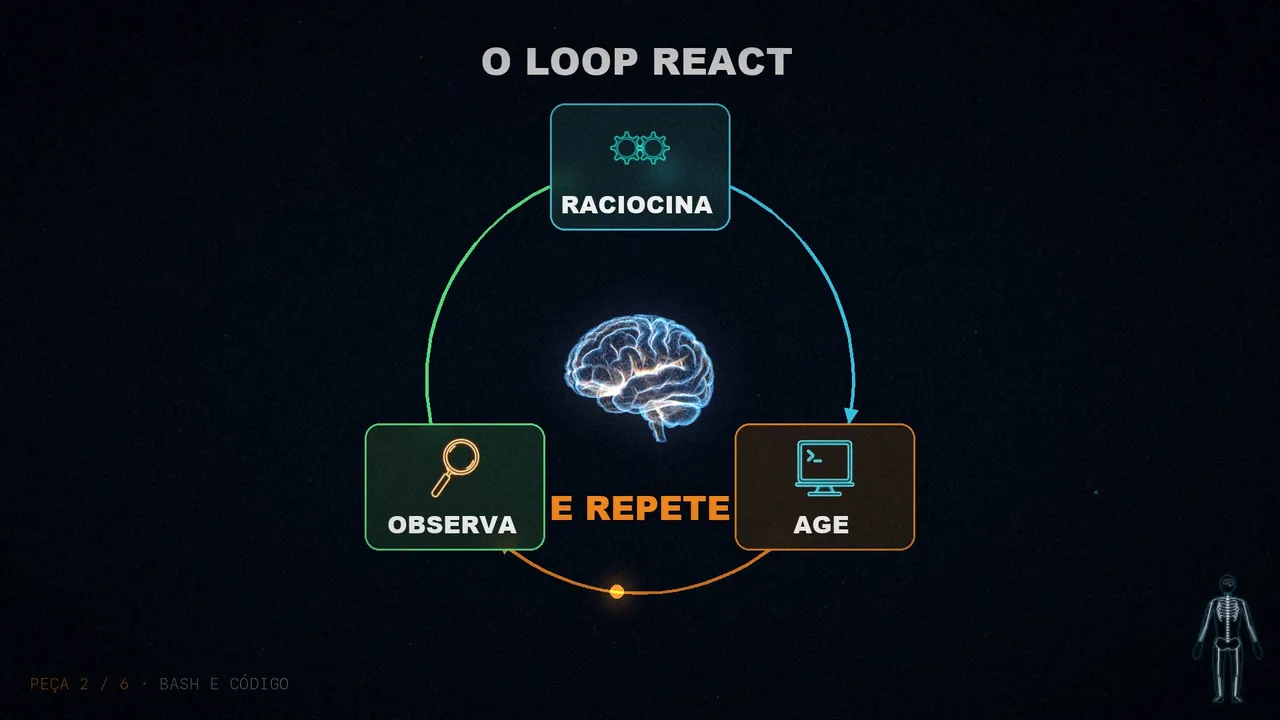
Queremos que o agente resolva problemas sozinho, sem que ninguém precise projetar antes cada ferramenta. O padrão habitual hoje é o loop ReAct: o modelo raciocina, age chamando uma ferramenta, observa o resultado e repete.
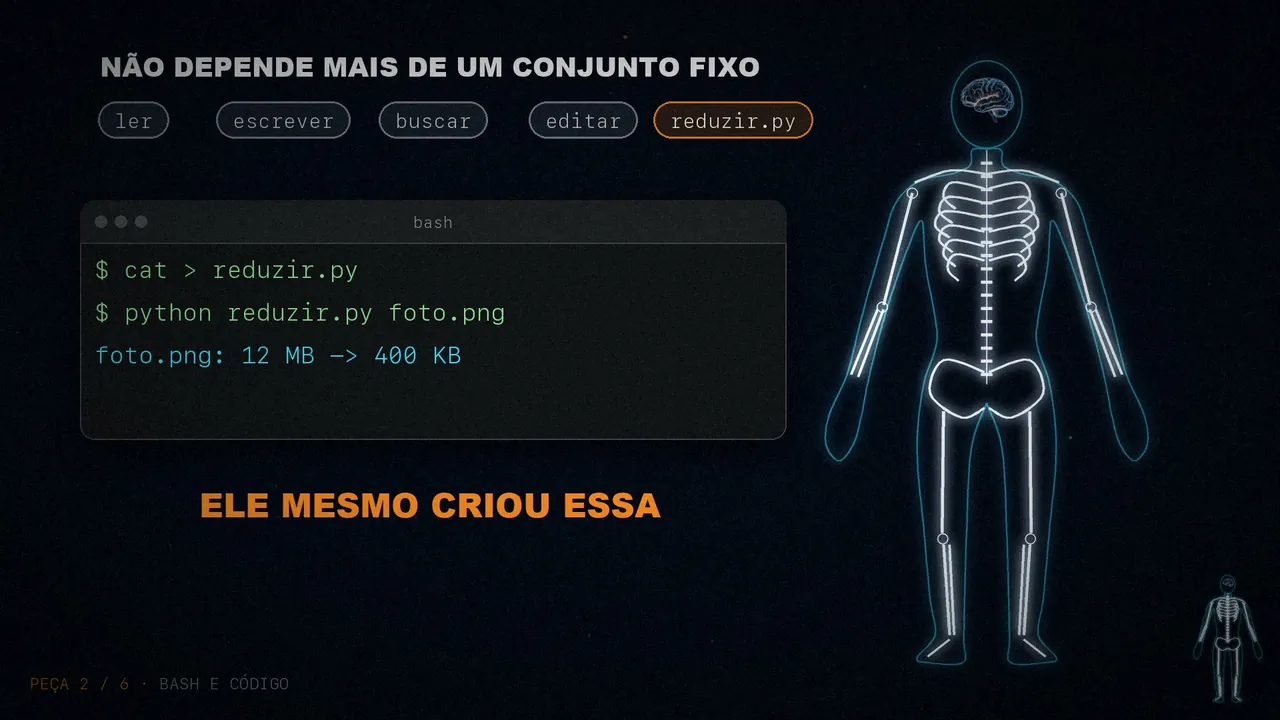
Mas o arnês só executa as ferramentas para as quais tem lógica. Em vez de programar uma para cada ação possível, é melhor dar a ele uma de uso geral: o bash. Assim o modelo resolve os problemas por conta própria, escrevendo e executando código.
É um grande passo para dar a ele um computador e deixar que se vire. Ele não depende mais de um conjunto fixo de ferramentas: cria as suas na hora. Os arneses continuam trazendo outras, mas executar código já é a estratégia padrão.
3. Ambientes isolados: a pele
Ele já consegue guardar e executar código, mas tudo isso precisa acontecer em algum lugar. Rodar na sua máquina o que um agente gera é arriscado, e ter só um ambiente local não escala quando a carga de agentes cresce.
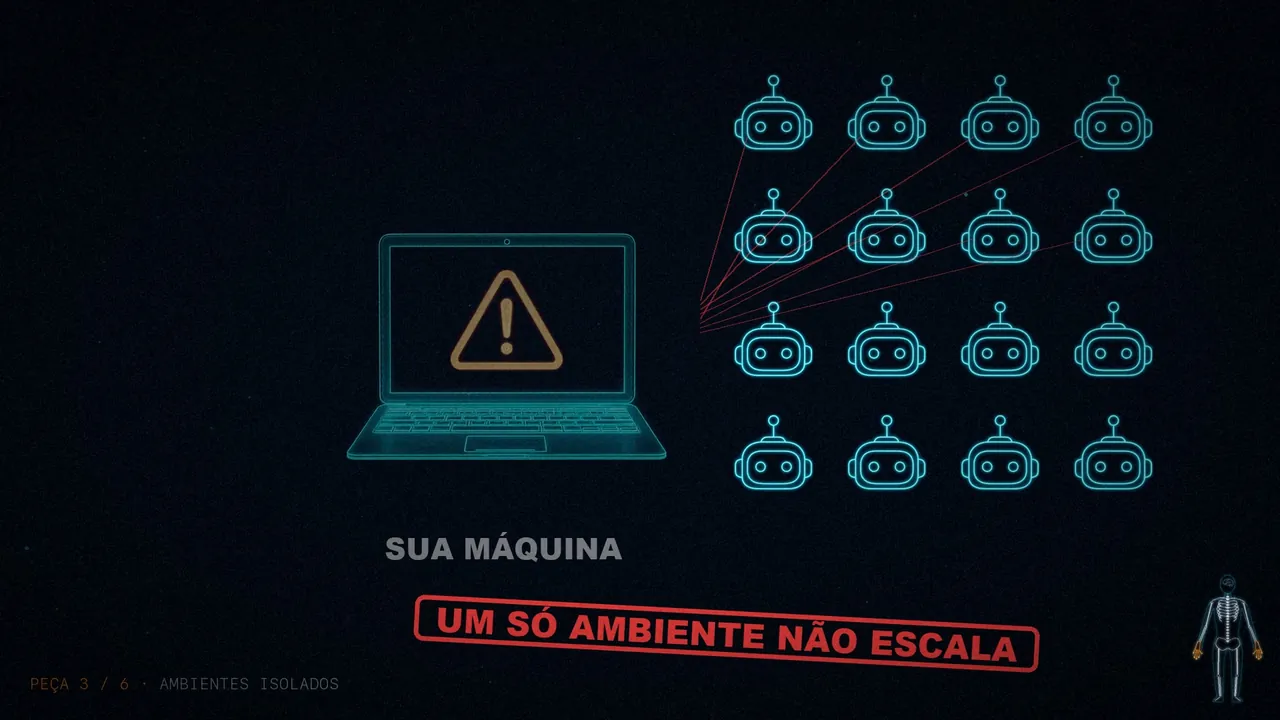
A resposta são os sandboxes, ambientes isolados e seguros. O arnês se conecta a um deles para executar código, olhar arquivos e instalar dependências. Se você quiser mais segurança, ele permite só uma lista de comandos e isola a rede. E eles também escalam: são criados sob demanda, distribuídos entre muitas tarefas e destruídos no final.
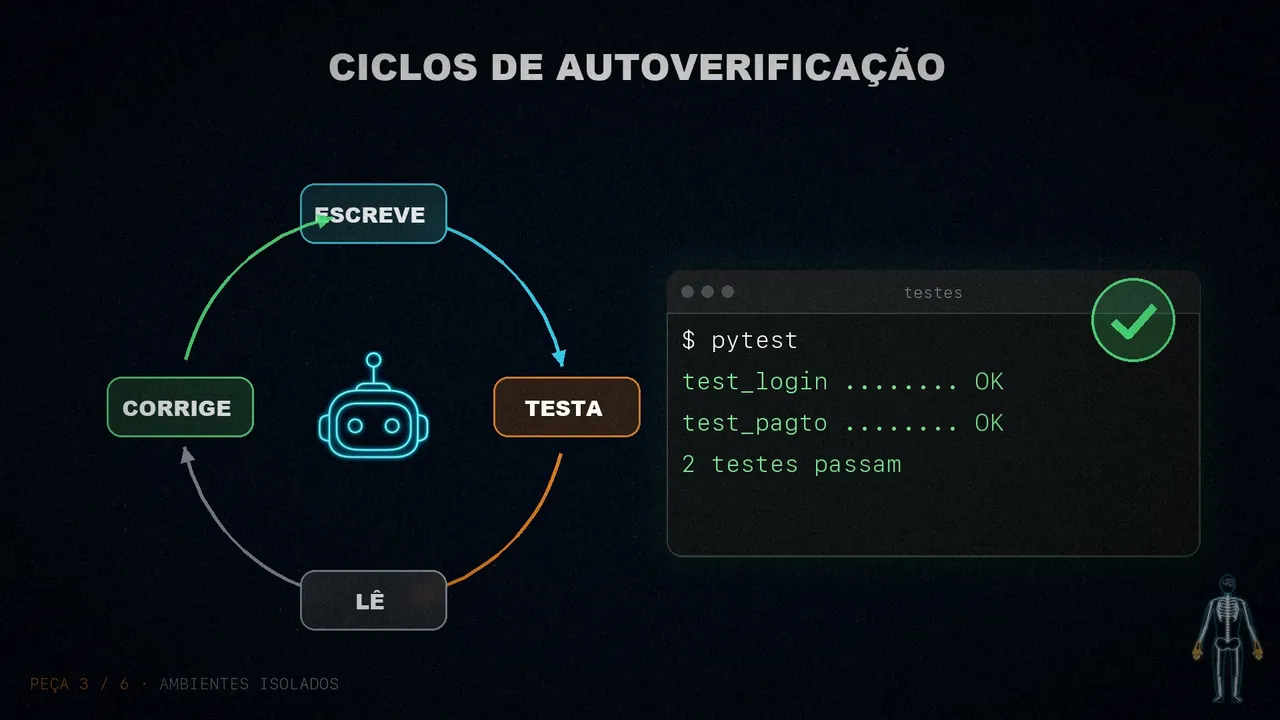
Bons ambientes trazem boas ferramentas de fábrica, e configurá-las é trabalho do arnês: linguagens e pacotes já instalados, linhas de comando para o git e para os testes, e navegadores para usar a web e conferir o que foi feito. Navegadores, registros, capturas e executores de testes permitem que ele observe o próprio trabalho, e assim nascem os ciclos de autoverificação: escreve o código, roda os testes, lê os registros e corrige os erros.
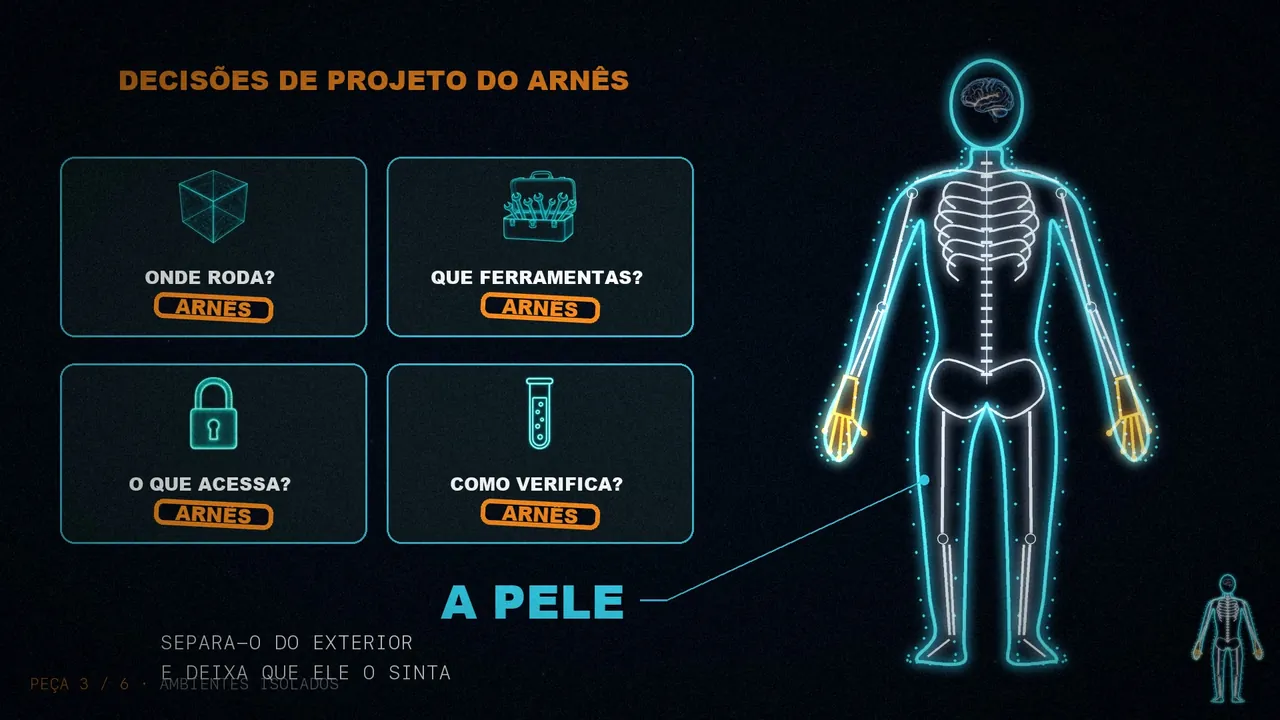
De fábrica, o modelo não configura o próprio ambiente. Onde ele roda, que ferramentas tem, o que pode acessar e como verifica o trabalho são decisões de projeto do arnês.
4. Memória e busca
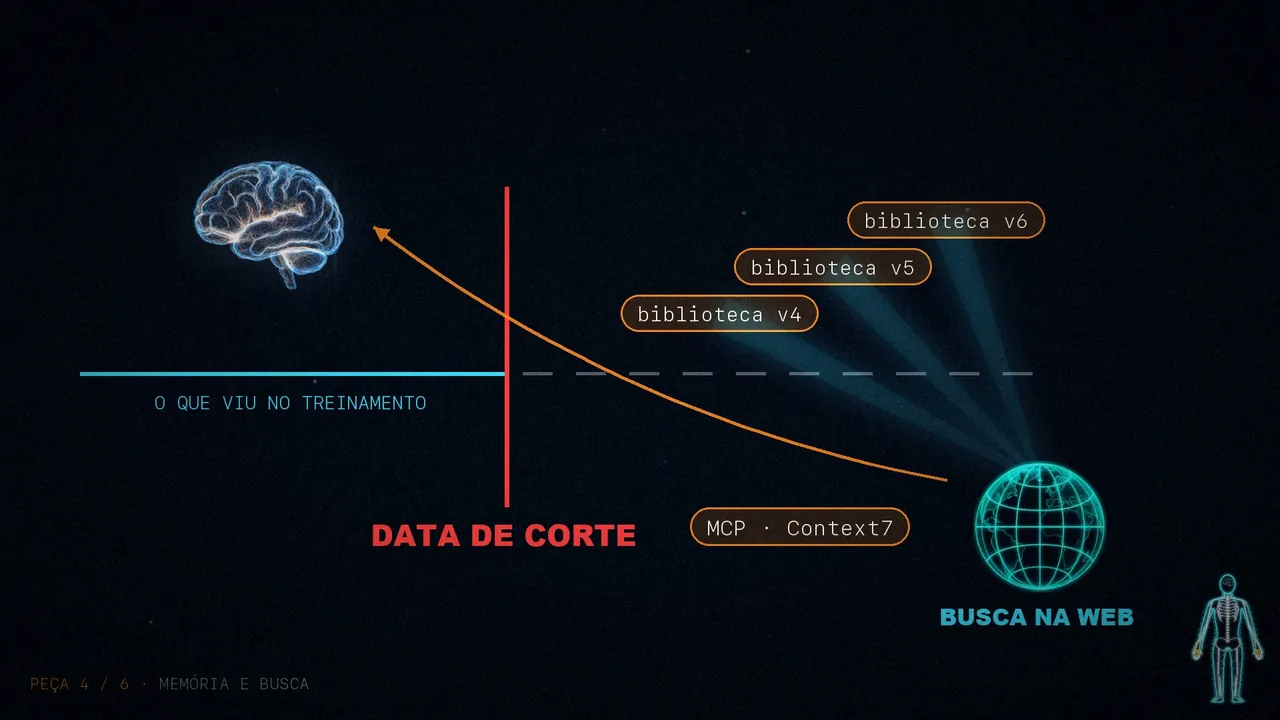
Queremos que ele lembre o que viu e que acesse o que não existia quando foi treinado. Mas um modelo só sabe o que está nos seus pesos e no seu contexto atual. Como não podemos editar esses pesos, a única via para acrescentar conhecimento é injetá-lo no contexto.
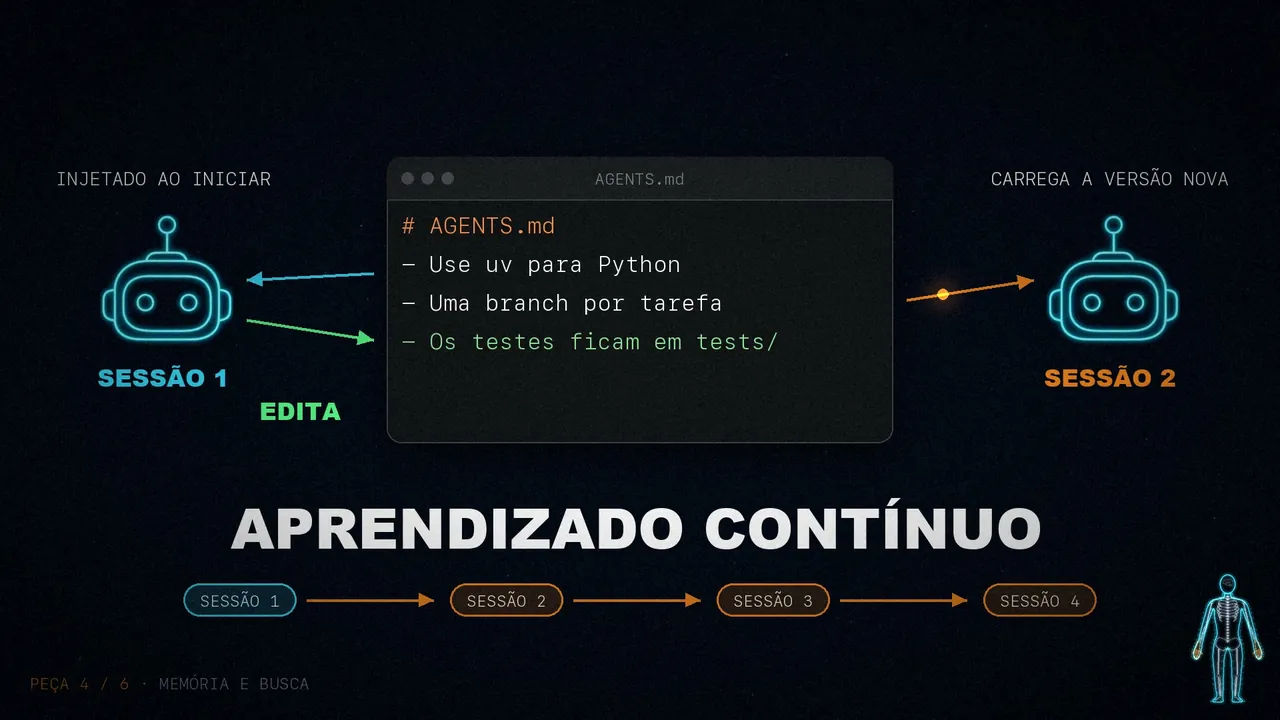
Para a memória, os arquivos voltam a ser a base. Os arneses aceitam padrões como AGENTS.md, que é injetado ao iniciar. Quando o agente o edita, o arnês carrega a versão nova. É uma forma de aprendizado contínuo: o que ele guarda numa sessão chega às seguintes.
Depois vem a data de corte. O modelo não conhece, por exemplo, a última versão de uma biblioteca, a menos que você a forneça. A busca na web e ferramentas MCP como o Context7 trazem o que não existia quando o treinamento acabou, então vale a pena integrá-las ao arnês.
5. Apodrecimento do contexto: o sistema imunológico
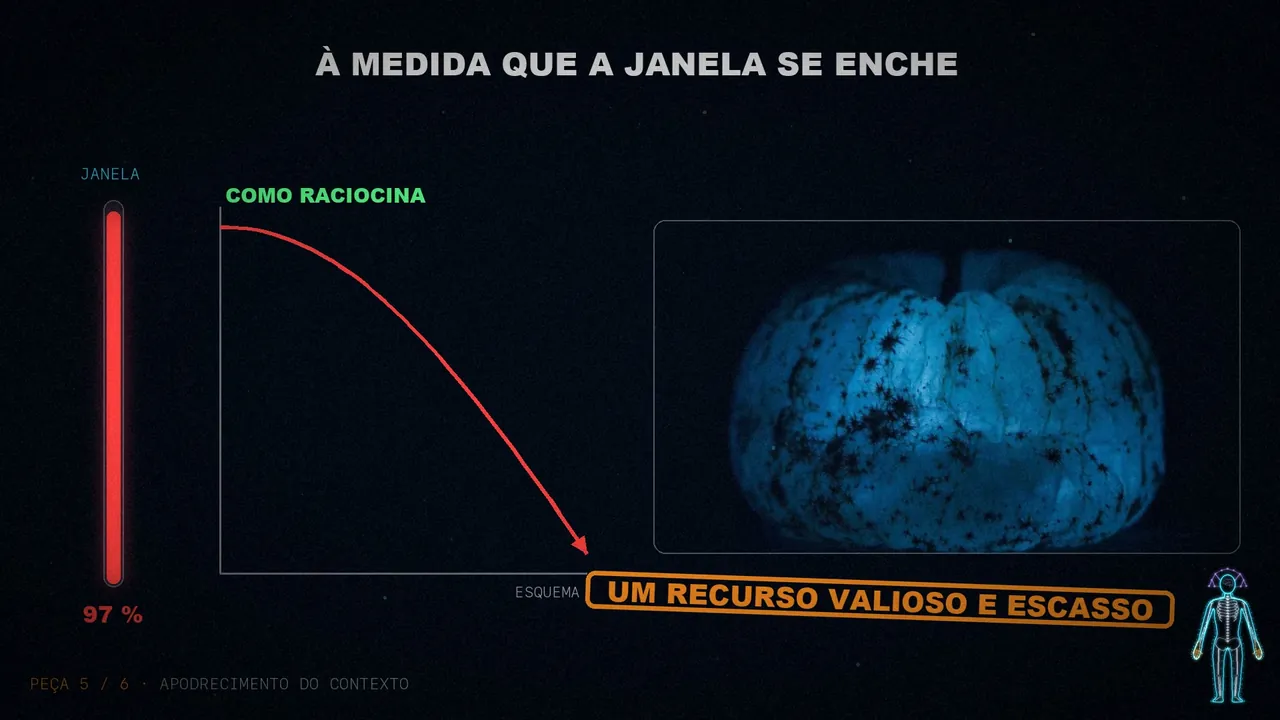
O context rot é isto: os modelos raciocinam pior e completam pior as tarefas à medida que a janela se enche. Esse espaço é um recurso valioso e escasso, então o arnês precisa de estratégias para administrá-lo. Vivek resume com uma frase forte: os arneses de hoje são, em grande medida, mecanismos para entregar uma boa engenharia de contexto.
O artigo cita três técnicas:
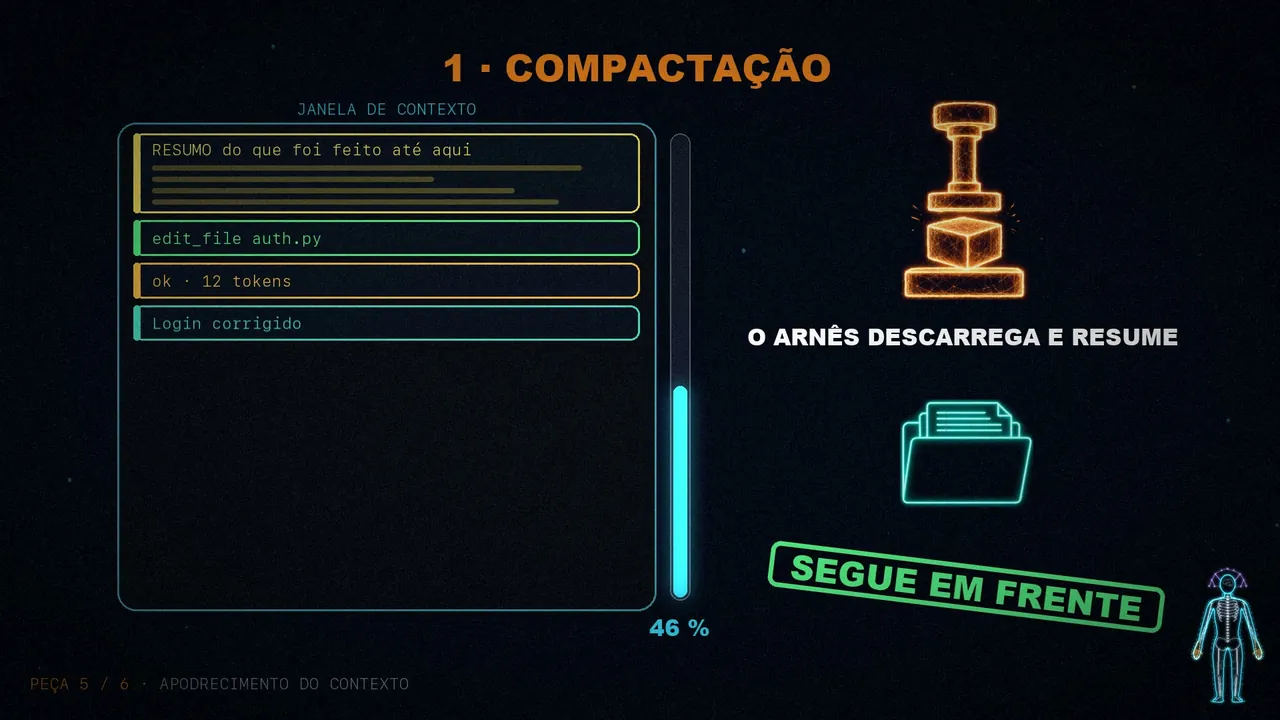
- Compactação. O que acontece se a conversa ultrapassa a janela? Uma opção é a API devolver um erro, e isso não é bom. Então o arnês descarrega e resume com inteligência o que existe, e o agente pode continuar trabalhando.
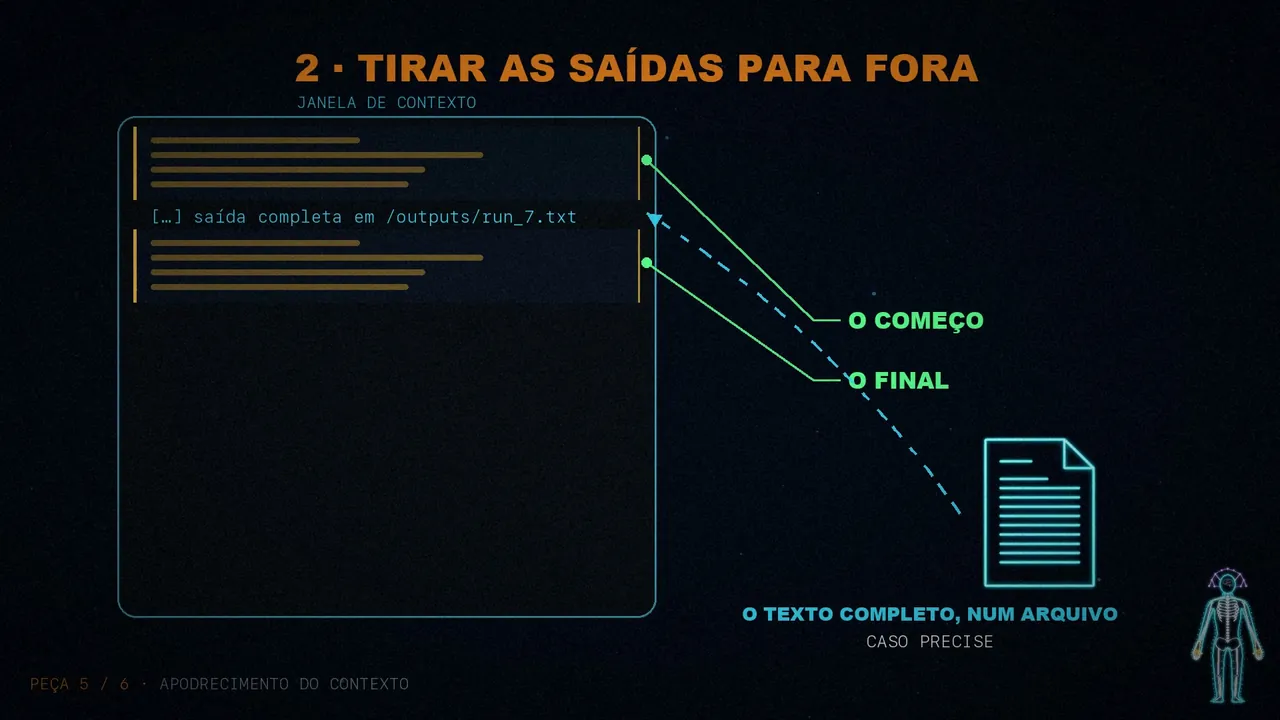
- Tirar para fora as saídas das ferramentas. As enormes enchem o contexto de ruído sem acrescentar nada útil. Se uma passa de certo limite de tokens, o arnês conserva o começo e o final e guarda o texto completo num arquivo, caso o modelo precise dele.
- Skills. Ter ferramentas ou servidores MCP demais carregados ao iniciar faz com que ele renda menos antes de começar. As skills evitam isso com revelação progressiva: no início só se carrega o cabeçalho delas. O modelo não escolheu isso; é o arnês que o protege.
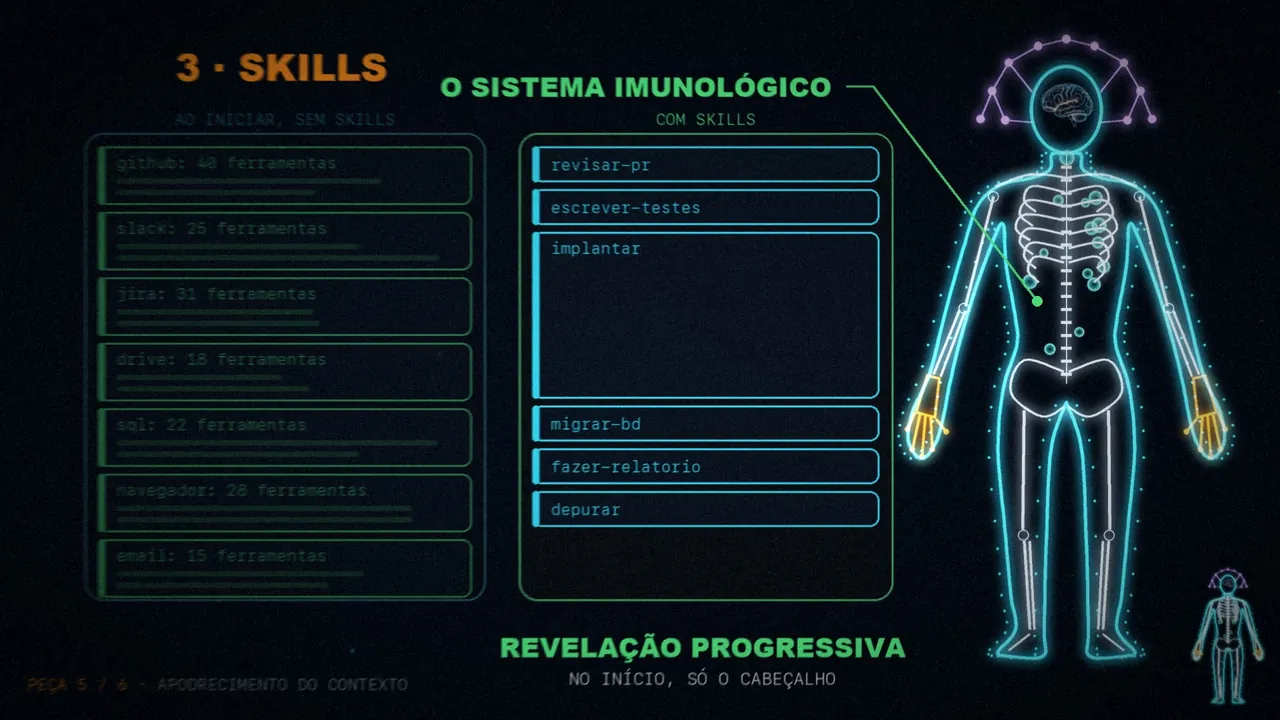
Se quiser se aprofundar, falo disso nos meus posts sobre compressão de contexto, gestão de contexto e engenharia de contexto.
6. Trabalho de longo prazo: o coração
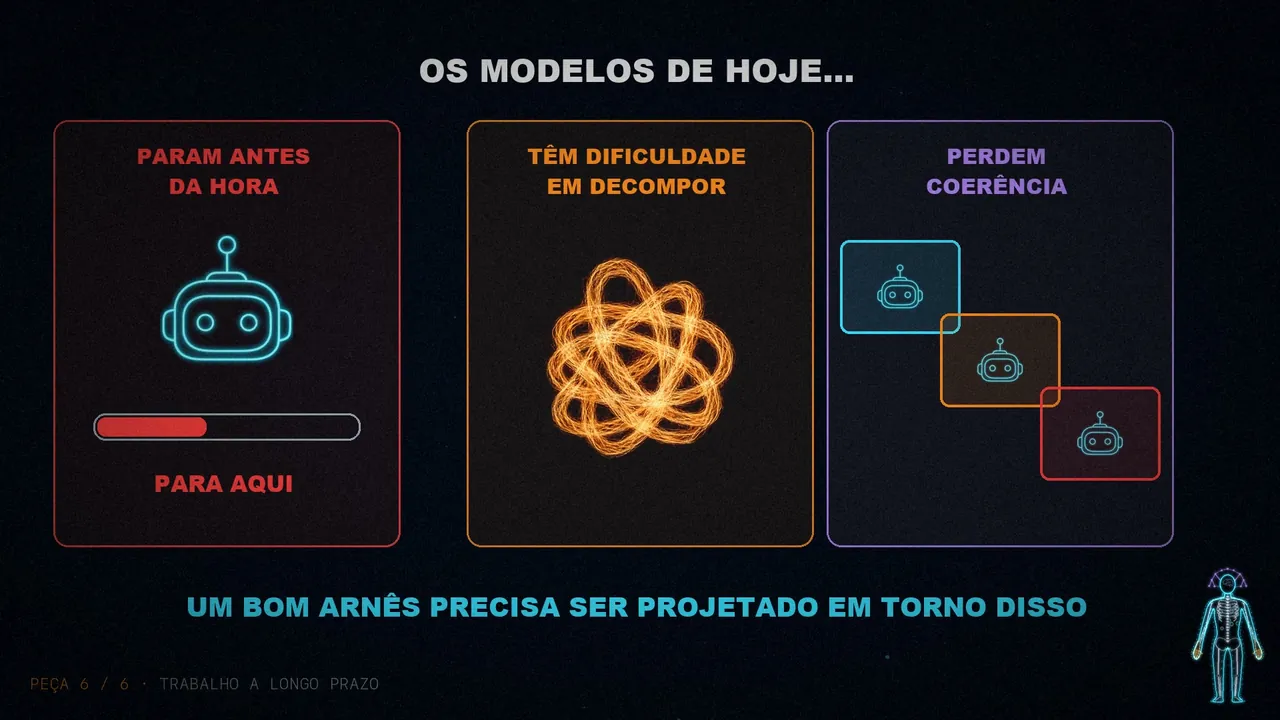
Criar software de forma autônoma é o santo graal dos agentes de programação. Mas os modelos de hoje param antes da hora, têm dificuldade em decompor problemas complexos e perdem coerência quando o trabalho se estende por várias janelas. Um bom arnês precisa ser projetado em torno disso tudo.
Aqui as peças anteriores começam a se somar: trabalhar a longo prazo exige estado durável, planejamento, observação e verificação.
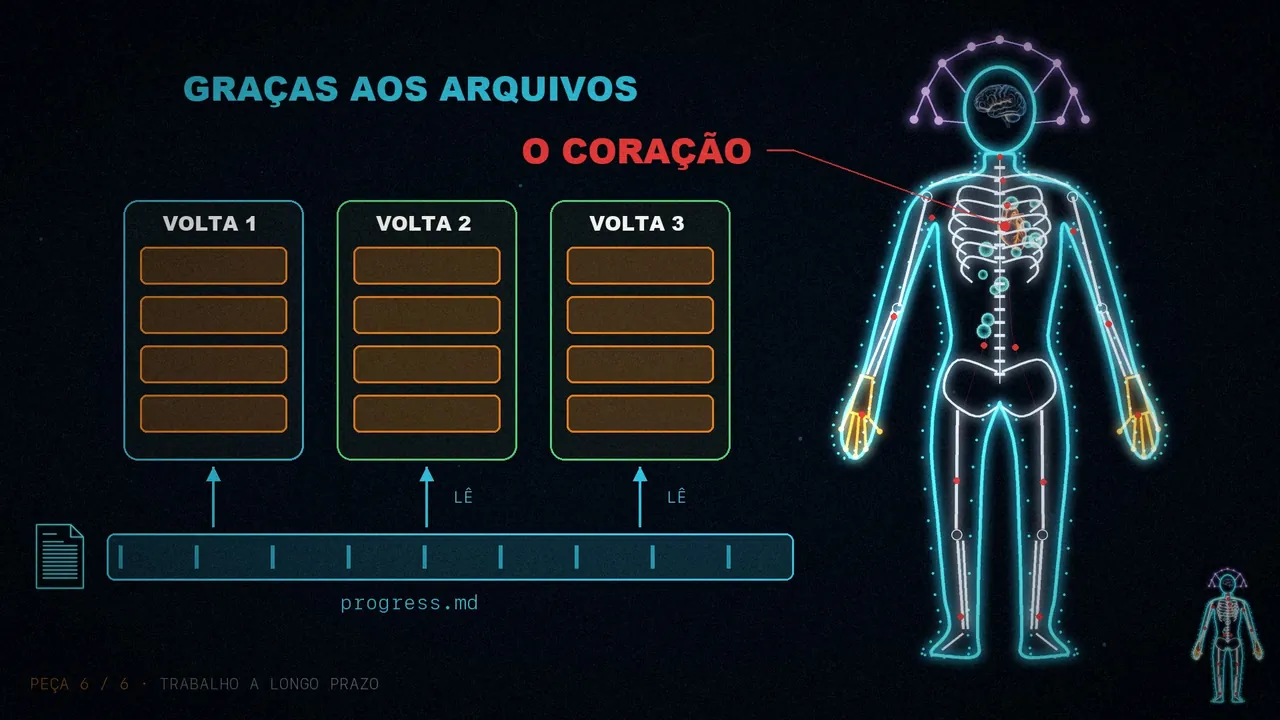
- Arquivos e git para acompanhar o trabalho. Numa tarefa longa, um agente produz milhões de tokens. Os arquivos guardam esse progresso, e o git permite que um recém-chegado se atualize logo. Para vários agentes, é também um registro compartilhado.
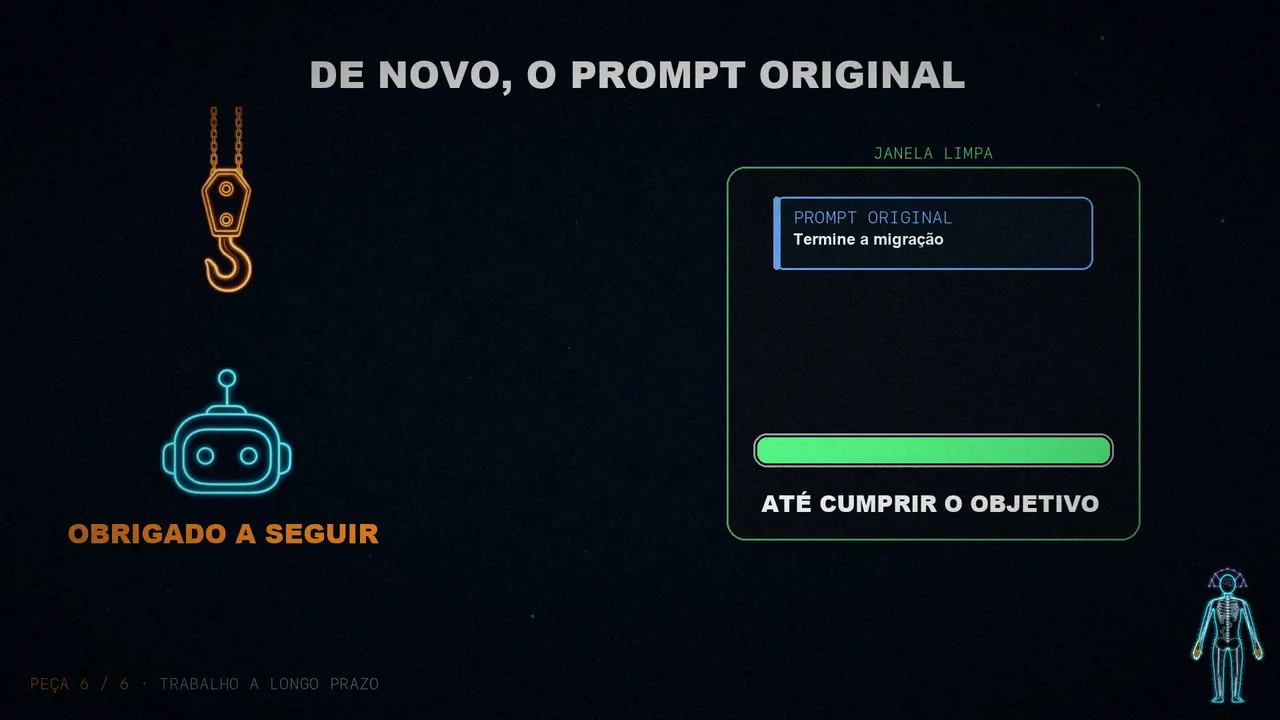
- O loop Ralph para que ele continue. Quando o modelo tenta terminar, um hook intercepta essa saída e injeta de novo o prompt original numa janela de contexto limpa. Assim ele é obrigado a seguir até cumprir o objetivo. Não parte do zero porque cada volta começa com o contexto fresco, mas lê nos arquivos o estado que a anterior deixou.
- Planejar e verificar para não perder o rumo. O modelo decompõe o objetivo em passos, e o arnês o apoia com bons prompts e lembretes sobre como usar um arquivo de plano. Ao concluir cada passo, os hooks podem rodar uma bateria de testes e, se falhar, devolver o erro. Também dá para pedir que ele avalie o próprio código de forma independente.
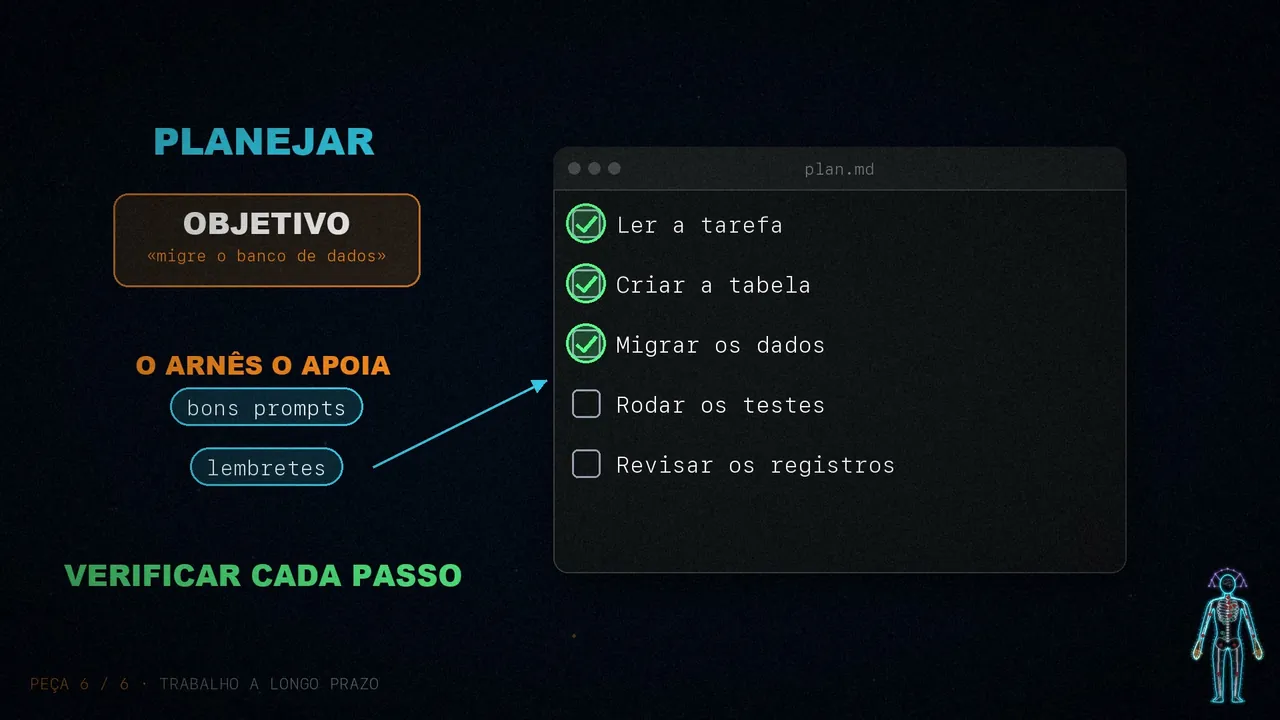
A verificação ancora a solução nessas provas e cria um sinal para melhorar.
O corpo inteiro
Está montado. O esqueleto de arquivos e git. As mãos de bash e código. A pele do sandbox. A memória e a busca. O sistema imunológico contra o apodrecimento. E o coração, que não para de bater até o trabalho terminar. Cada parte nasceu de algo que o cérebro não conseguia fazer sozinho.
Modelo e arnês, treinados juntos
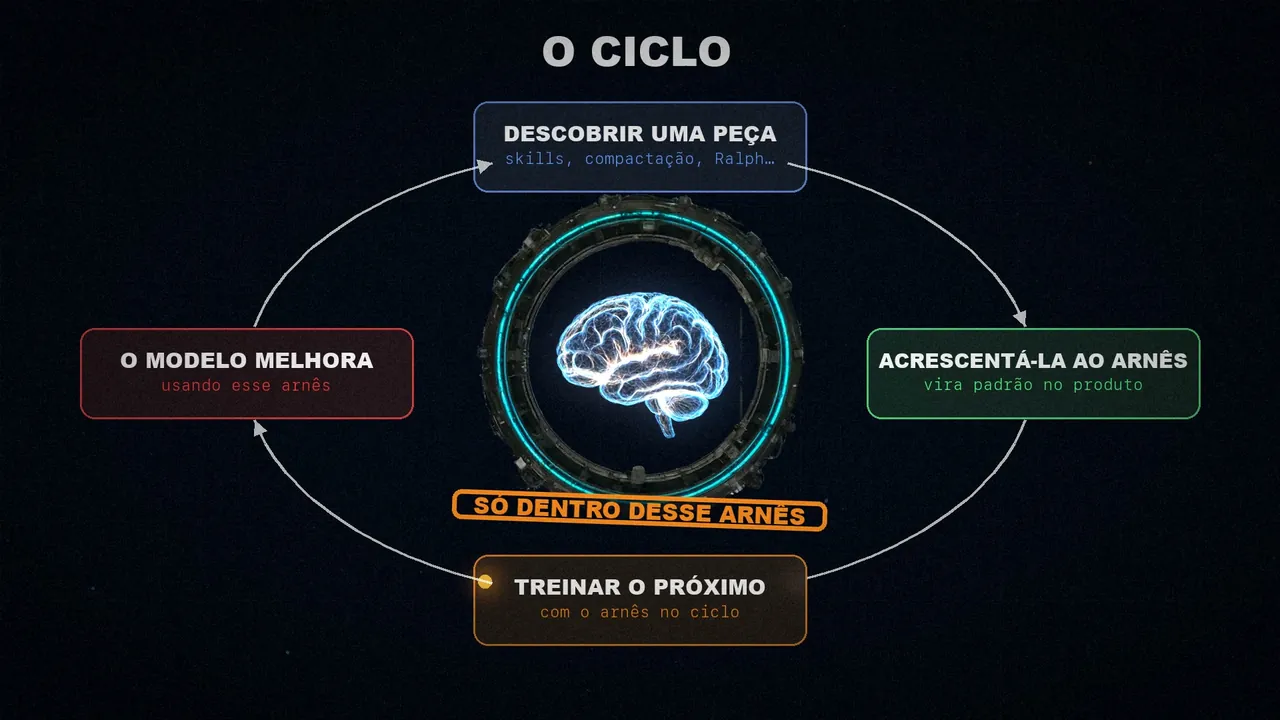
Produtos como Claude Code e Codex são pós-treinados com o modelo e o arnês no ciclo. Assim o modelo melhora no que os seus criadores acham que ele deveria fazer bem de forma nativa: operar com arquivos, executar bash, planejar ou dividir o trabalho entre subagentes.
Isso cria um ciclo: uma peça útil é descoberta, acrescentada ao arnês e usada para treinar a geração seguinte. A cada repetição, o modelo fica mais capaz, mas dentro do arnês com que foi treinado.
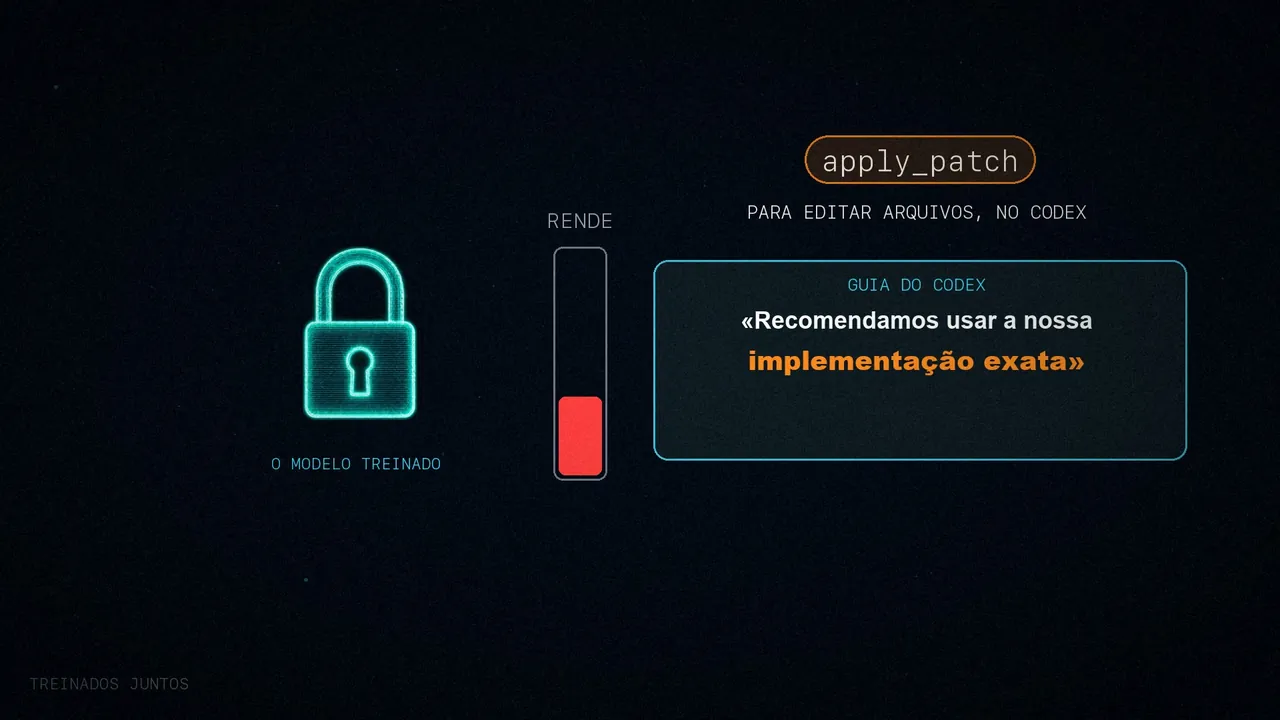
Essa evolução conjunta tem um efeito colateral: se você muda a lógica de uma ferramenta, ele rende menos. O exemplo é o apply_patch, o utilitário que o Codex usa para editar arquivos. O guia dele recomenda usar essa implementação exata, porque o modelo foi treinado com esse formato. Algo realmente inteligente mudaria de método sem problema; treinar assim provoca sobreajuste.
Mesmo assim, o melhor arnês para a sua tarefa não precisa ser aquele com que o modelo foi treinado. O Terminal Bench 2.0 é um bom exemplo: segundo o artigo, quando ele foi escrito, o Opus 4.6 dentro do Claude Code pontuava muito abaixo do mesmo Opus 4.6 em outros arneses. Não consegui comprovar isso: a página do Terminal Bench já mostra outra versão.
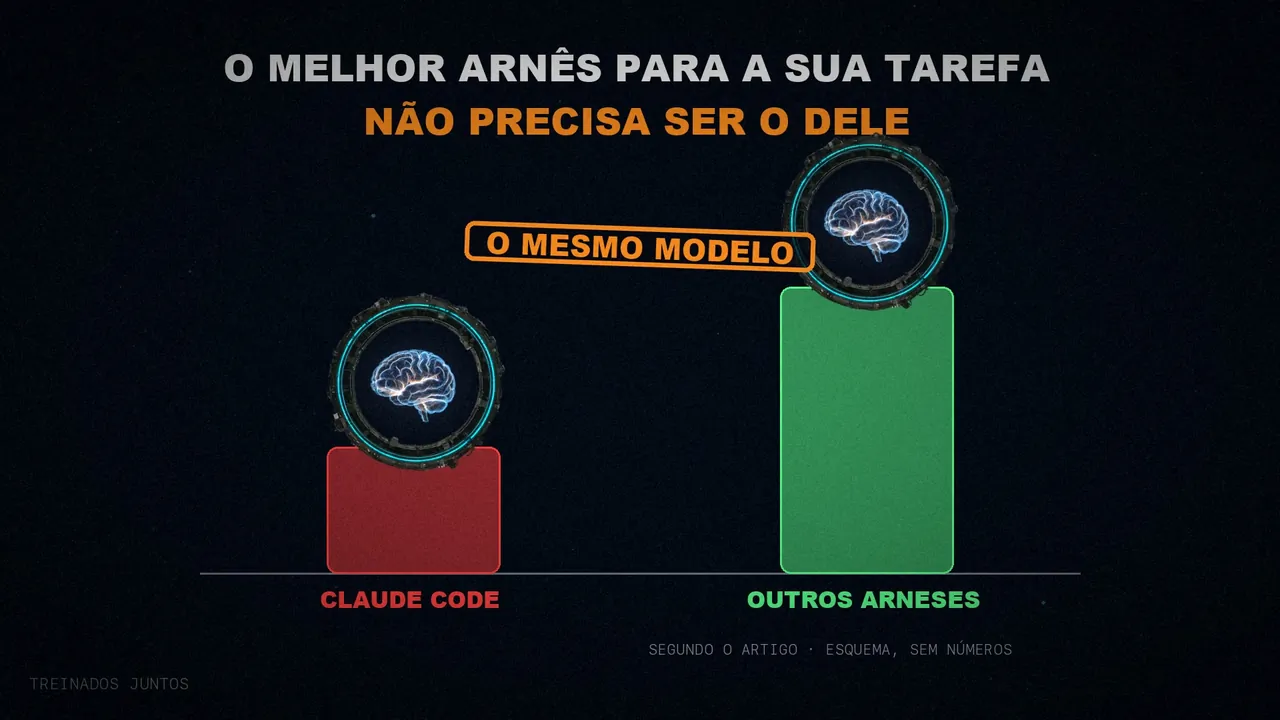
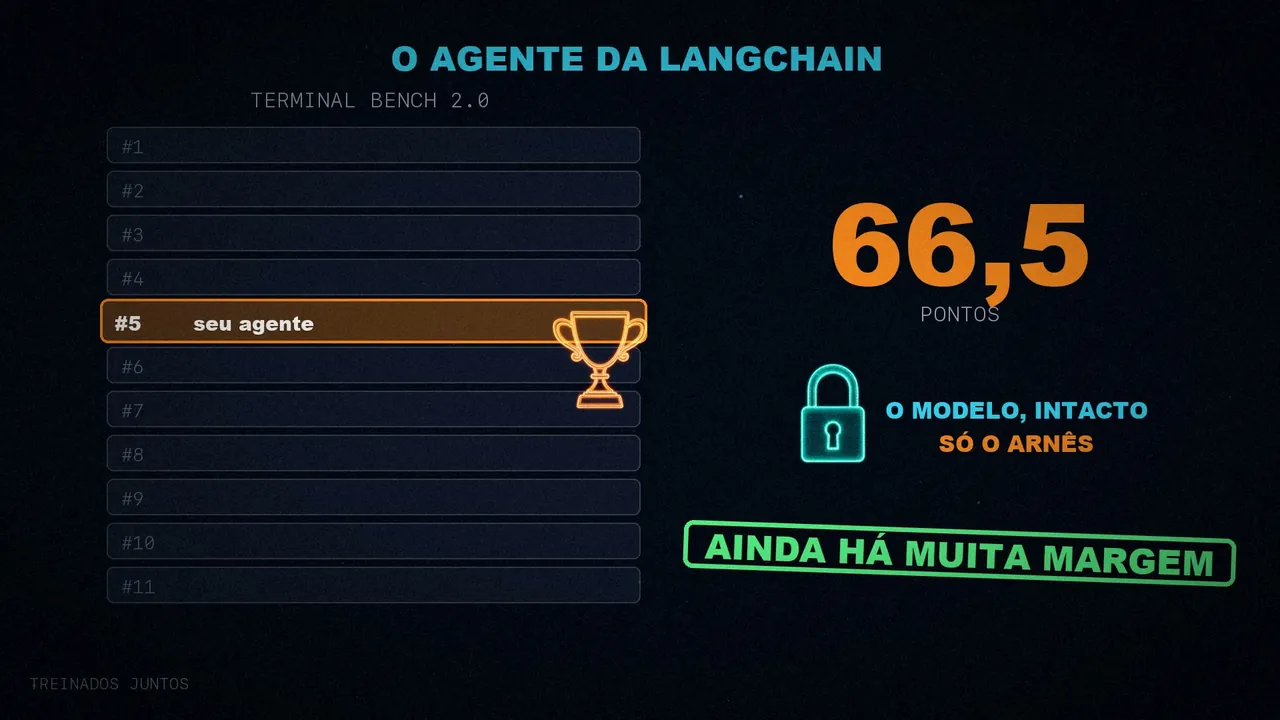
A LangChain comprovou isso com o seu próprio agente de programação: passou do 30º lugar ao top 5 só mudando o arnês, de 52,8 a 66,5 pontos, sem tocar no modelo (GPT-5.2-Codex). Ainda há muita margem para melhorar se você o otimizar para a sua tarefa.
Para onde vai
À medida que os modelos melhorarem, parte do que hoje vive no arnês vai acabar dentro deles. Vão planejar, verificar o próprio trabalho e manter a coerência melhor de forma nativa, e precisarão de menos contexto injetado. Isso sugere que o arnês vai importar cada vez menos.
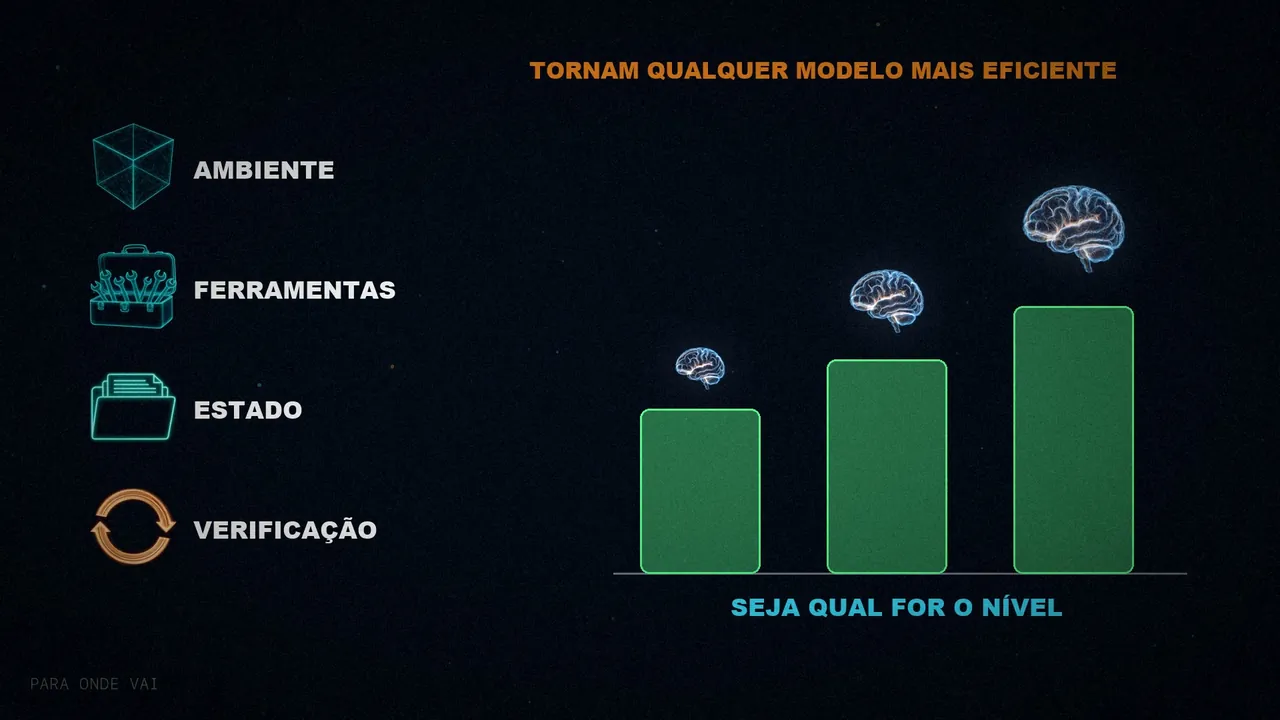
Mas Vivek acredita que ele continuará sendo útil, assim como a engenharia de prompts continua sendo hoje. É verdade que os arneses remendam deficiências, mas também constroem sistemas em torno da inteligência. Um ambiente bem configurado, boas ferramentas, estado durável e ciclos de verificação tornam qualquer modelo mais eficiente, seja qual for o nível.
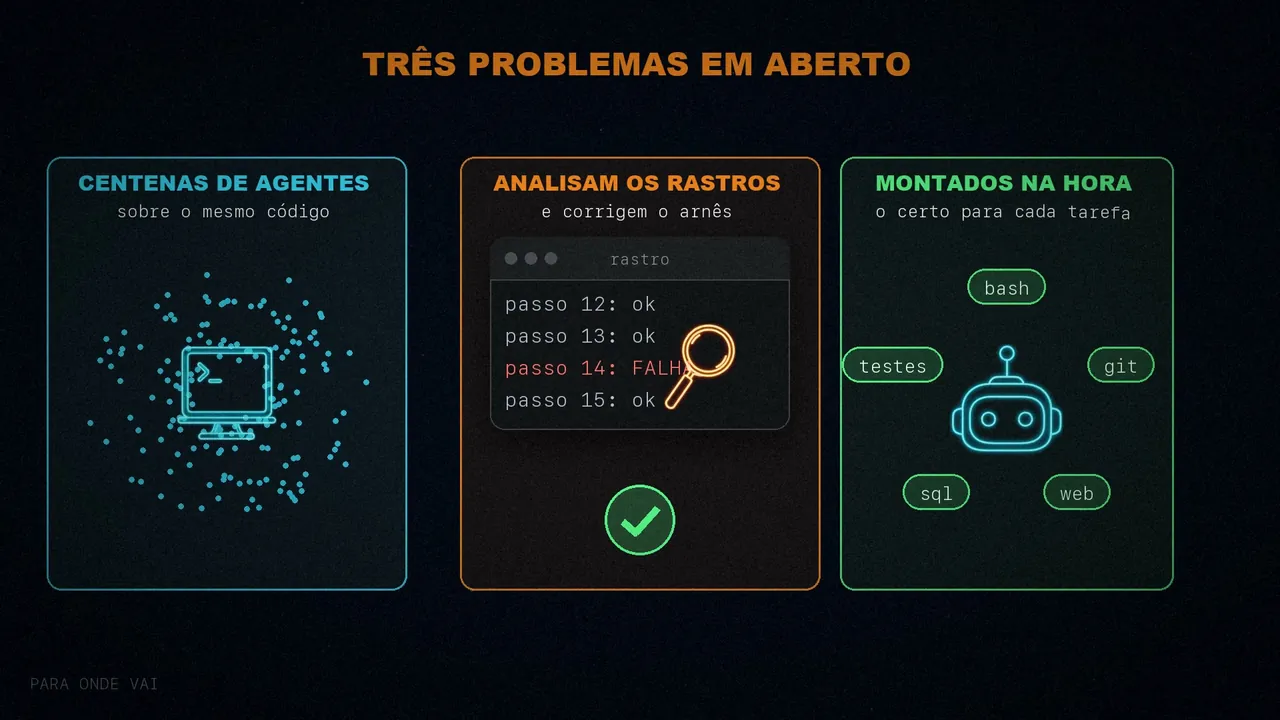
Por isso continua sendo uma área de pesquisa muito ativa. Na LangChain, ela é usada para melhorar a biblioteca deepagents, e são citados três problemas em aberto:
- Orquestrar centenas de agentes em paralelo sobre o mesmo código.
- Fazer os agentes analisarem os próprios rastros para encontrar e corrigir as falhas do arnês.
- Arneses montados na hora, com as ferramentas e o contexto certos para cada tarefa, em vez de virem pré-configurados.
Em resumo
Cada peça do arnês existe por causa de algo que o modelo não consegue fazer sozinho: guardar, agir, executar com segurança, lembrar, manter o contexto limpo e continuar trabalhando. E como o modelo é treinado dentro de um arnês, mudar esse arnês pode render mais do que trocar de modelo.
O modelo contém a inteligência, e o arnês é o sistema que a torna útil.
Qual peça do arnês deu mais resultado para você?
Fontes
- «The Anatomy of an Agent Harness», de Vivek Trivedy (@Vtrivedy10), LangChain, 10 de março de 2026.
- As pontuações no Terminal Bench 2.0: a publicação que o artigo cita.
- O guia do Codex sobre
apply_patch: Codex Prompting Guide. - Outro artigo sobre o mesmo tema, que também expliquei: «The Harness Is The Product».
- O vídeo, nos meus três canais: espanhol, inglês e português.